基于英特尔至强6打造KV Cache存储,加速智能体AI推理。
智能体AI不仅需要处理更复杂的任务流程,频繁调用工具,还需要长时间工作,在多轮交互中保留上下文信息。这不仅需要更多计算资源,需要智能体能保持工作记忆,具体表现,就是对数据存储的容量、性能和访问效率提出了更高要求。
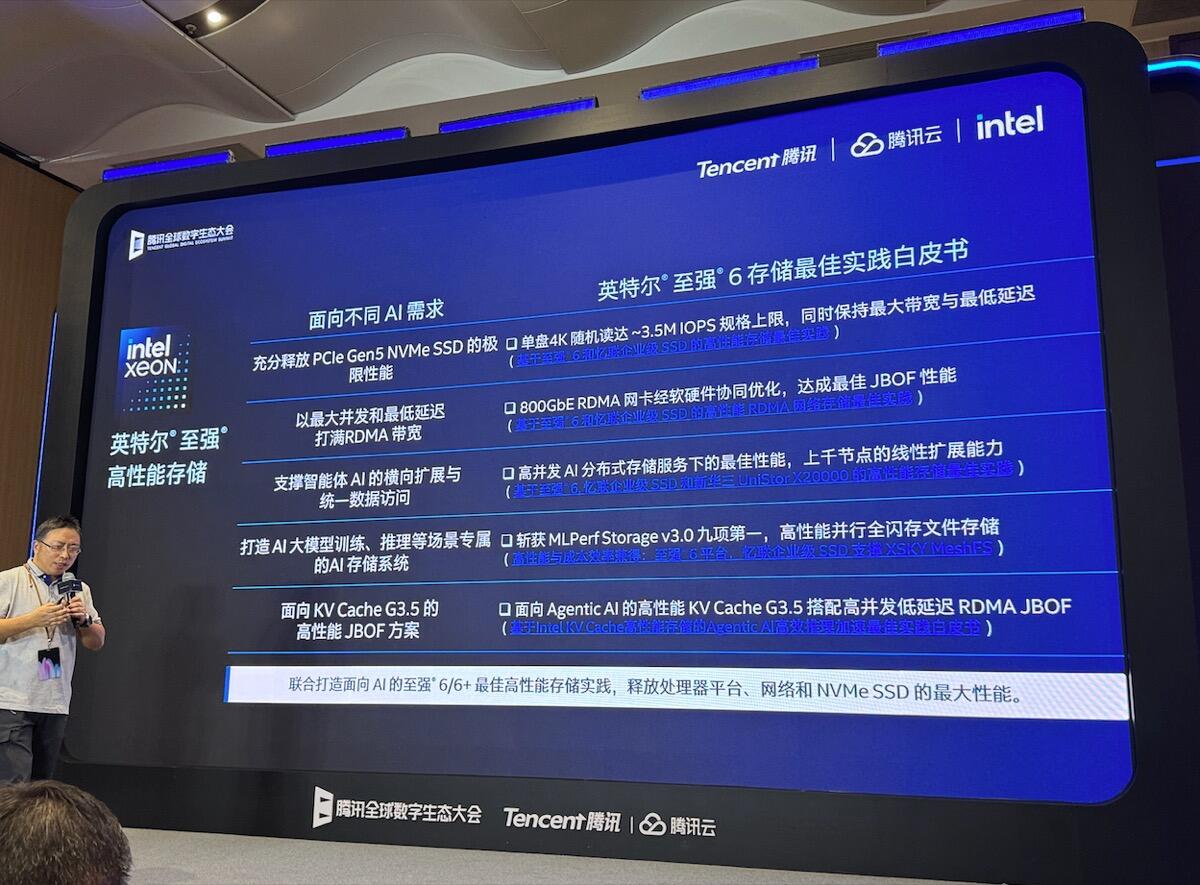
10月30日,在2026腾讯全球数字生态大会期间,英特尔数据中心集团资深存储架构师曹刚介绍了如何基于至强6处理器,从硬件加速器到软件优化进行组合,帮助用户搭建存储KV Cache的G3.5层,打造智能体AI存储平台,提升AI推理效率。
智能体AI带来新的存储需求
传统的大模型应用以问答为主,用户提出问题,模型生成答案,交互流程相对简单。而智能体AI需要持续执行任务,在多个步骤之间保持上下文,并利用已有信息完成后续操作,这一变化使KV Cache变得非常重要。
KV Cache是大模型推理过程中生成的键值缓存,可以保存已经处理过的上下文计算结果。当后续请求能够复用这些缓存时,就不必重新计算相同的内容,从而缩短响应时间,降低计算开销,本身是个好东西。
不过,随着上下文长度和并发规模增长,KV Cache也会迅速膨胀。容量有限、成本较高的GPU显存难以独自承担全部缓存,因此需要逐级扩展到CPU内存、本地NVMe SSD、RDMA JBOF以及后端分布式存储。
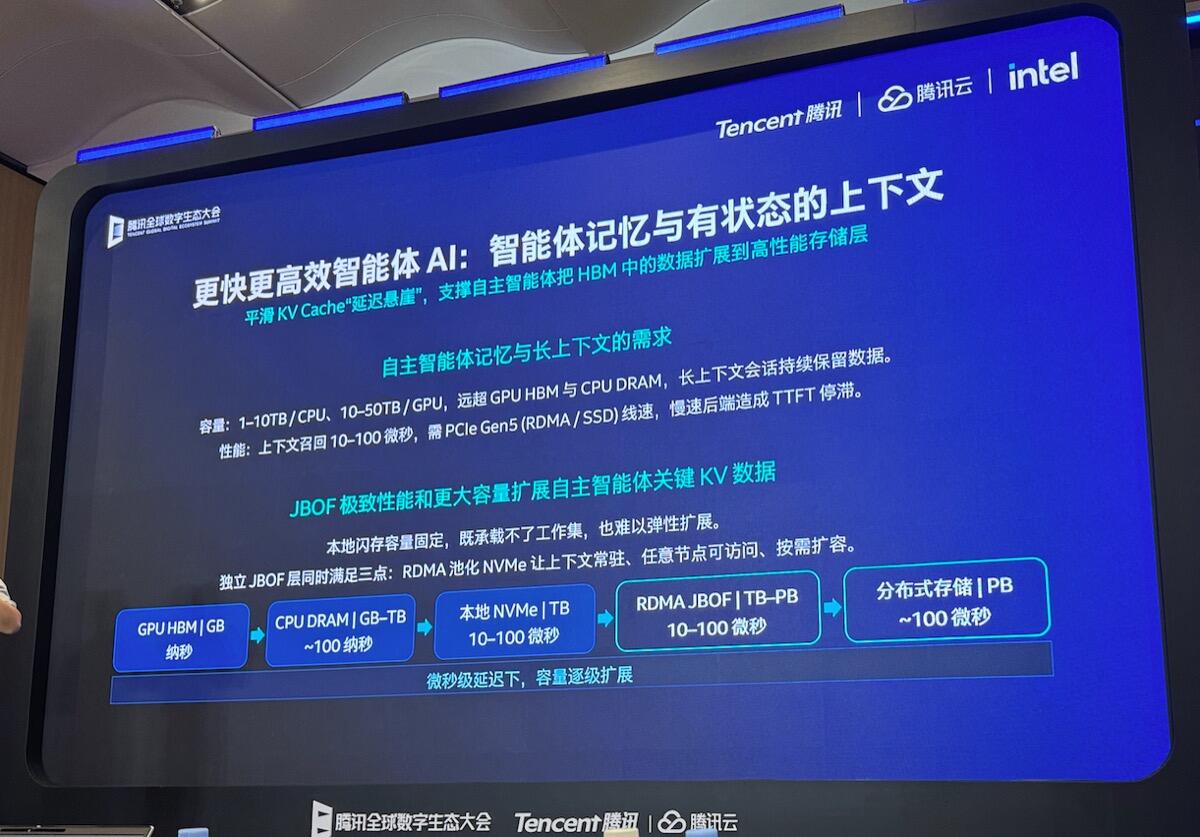
KV Cache存储问题是过去一年来AI基础设施最热的话题之一,如何让更大容量的存储真正服务于KV Cache?英特尔提出了四个方向:大容量、高性能、高能效和易部署。关键是让不同存储层级协同工作,在扩容的同时控制访问延迟。
通过存算分离,实现KV Cache高效复用
针对智能体AI的需求,英特尔展示了一套基于至强6处理器的存算分离架构。该方案通过高速RDMA网络,将GPU计算节点与高性能存储系统连接起来,构建跨GPU显存、CPU内存、SSD存储、RDMA JBOF的多层级KV Cache体系。
这套方案采用KVShrink搭配JBOF存储的方式,扩展vLLM的KV Cache能力。前端GPU计算节点通过RDMA访问后端NVMe存储。方案还用SPDK优化存储性能,用RDMA Zero Copy减少数据搬运开销,使已有缓存能够更快返回计算节点。

至强6处理器集成的英特尔快速辅助技术(QAT)则用于在线压缩KV Cache相关数据。经过QAT的无损压缩之后,可节省约30%的空间。这意味着可以减少需要传输的KV Cache数据量,从而提高传输效率。
这套方案利用容量更大、成本相对较低的后端存储,为GPU提供可复用的计算缓存。对于需要处理大量重复上下文、长任务流程和高并发请求的智能体应用而言,这有望提高GPU资源利用率,并改善整体推理效率。
实测:首Token延迟最高降低约90%,缓存复用显著提升吞吐量
英特尔还展示了一组实际测试数据,说明大容量存储对AI推理性能的提升效果。测试采用Qwen2.5-32B-Instruct模型,重点比较了不同KV Cache复用方式下的性能表现。简单来说,就是看把之前计算过的KV Cache数据保存下来,在后续推理时直接使用,能多大程度上减少重复计算。
第一组测试对比了原生vLLM不复用历史KV Cache,以及通过JBOF存储系统实现100%缓存命中的情况。结果显示,使用JBOF复用已有缓存后,首Token生成时间(TTFT)降低了约90%。在更高并发请求下,系统吞吐量会有进一步提升。
第二组测试比较了DDR内存和JBOF存储方案。虽然DDR内存的访问速度更快,但容量有限,可能无法保存全部需要复用的KV Cache。相比之下,JBOF可以利用大容量SSD保存更多缓存数据。
测试中,DDR方案的缓存命中率为80%,JBOF方案则达到100%。在这一条件下,JBOF方案的推理吞吐量约为DDR方案的1.6至2倍。这说明,虽然SSD的访问速度不如内存,但如果能够减少更多重复计算,仍然可以提高系统整体性能。

此外,英特尔还测试了开启QAT硬件压缩后的效果。开启压缩后,系统吞吐量变化不大,首Token生成时间受到约10%的影响,但可用存储容量提升超过20%。这意味着,同样的存储空间可以保存更多KV Cache,有助于进一步提高缓存复用率。
这些测试说明,对于需要频繁处理相同或相似上下文的智能体AI应用,大容量高性能存储如果保存更多已经计算好的KV Cache,确实可以让GPU减少重复计算,从而加快响应速度,提高系统吞吐量。
充分释放NVMe SSD的性能,满足KV Cache的高并发、小IO需求
除了KV Cache复用,曹刚还重点介绍了至强6平台在高密度NVMe SSD存储场景下的性能优化。随着企业级SSD性能持续提升,单块高性能NVMe SSD的顺序读取带宽已经达到十几GB/s,随机IOPS也达到数百万级。但在实际存储服务器中,配置更多SSD并不意味着能够直接获得相应的性能提升。
当一台服务器搭载十几块甚至24块NVMe SSD时,CPU处理能力、PCIe带宽、软件IO路径以及系统调度效率,都可能成为制约整体性能的因素。为此,英特尔通过处理器、存储软件和IO路径的协同优化,提高多盘并发访问效率。
测试数据显示,经过优化的至强6存储平台,在相关测试条件下可以发挥SSD标称性能的80%至100%。
在配置24至30块PCIe Gen5 NVMe SSD的至强6 E-core(144核)测试平台上,高压力条件下的4K随机读单盘性能约为270万IOPS。注意啊,这里的270万IOPS是单盘指标,不是整机总IOPS。
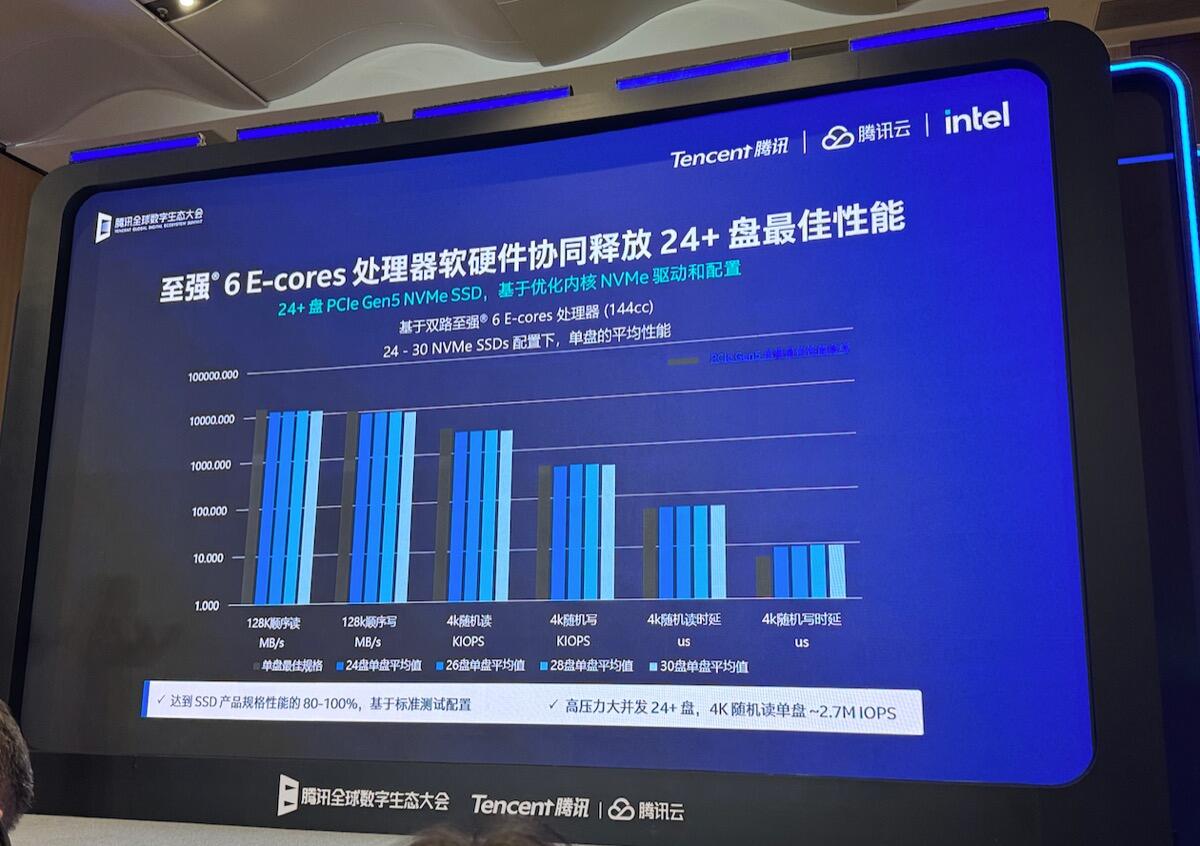
这一能力对于智能体AI尤为重要。与传统的大文件顺序读写不同,KV Cache访问可能涉及大量小IO、高并发和低延迟请求。后端存储系统不仅需要足够大的容量,还需要SSD能够快速响应大量并发访问。
从性能到能效,降低存储基础设施成本
除了性能,英特尔还通过SPDK与至强处理器的软硬件协同,优化存储服务器的功耗和运行效率。SPDK是一套高性能存储软件框架,能够减少SSD读写过程中的软件开销。它通常采用轮询方式,让CPU持续检查IO任务的完成情况。这种方式响应速度快,但即使没有新的任务,CPU也可能持续消耗资源。
针对不同的业务需求,英特尔展示了三种IO执行模式:纯轮询模式追求最高性能,内核态中断模式更注重节能,而结合UINTR和TPAUSE技术的用户态中断模式,则希望兼顾性能与功耗。
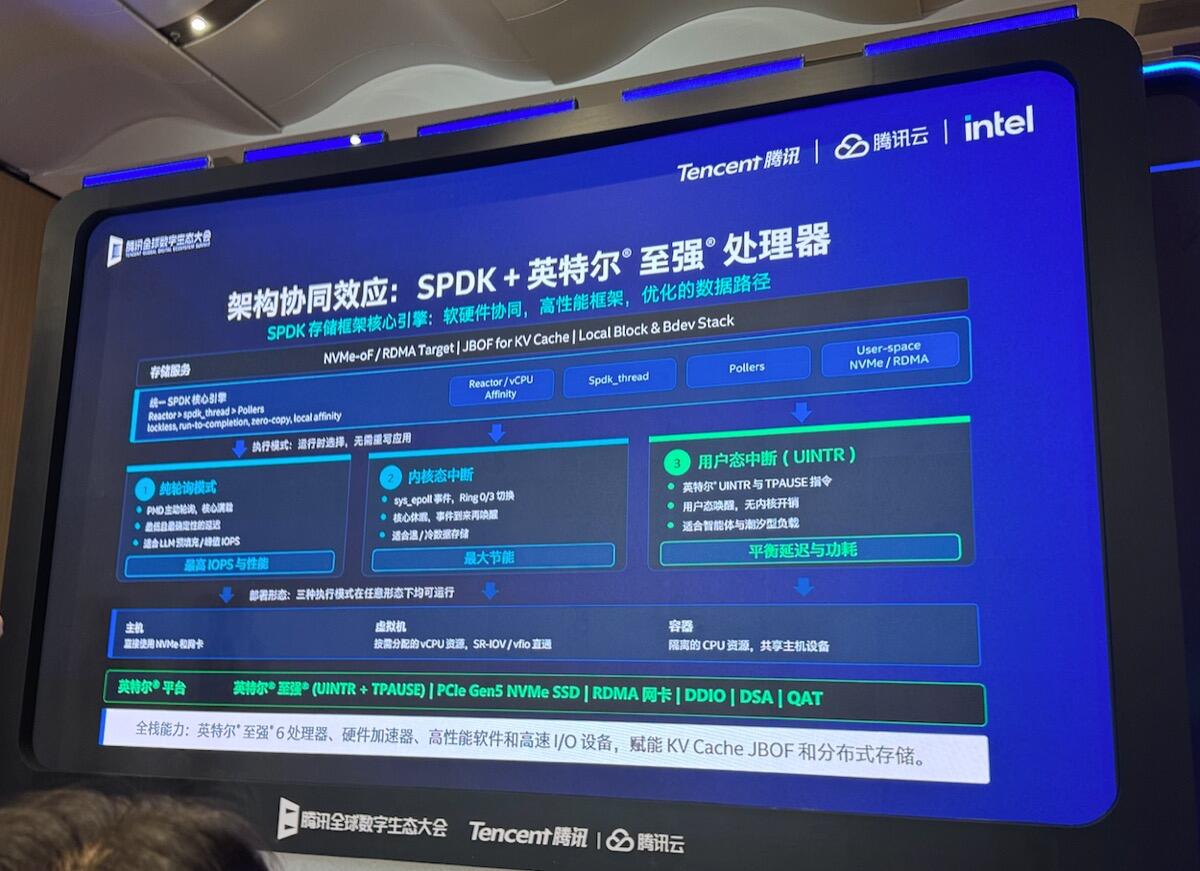
UINTR(用户态中断)和TPAUSE(定时暂停)是啥?简单说,UINTR让CPU能够更高效地接收任务通知,TPAUSE则让CPU在没有任务时减少无效工作。两者结合,有助于在保持高性能的同时,降低CPU资源占用和系统功耗。

英特尔测试数据显示,在4K随机读低负载场景下,处理器能效提升37%,整机能效提升11%,相同性能下CPU资源节省27%;在128K顺序读高负载场景下,三项指标分别为17%、6%和14%。
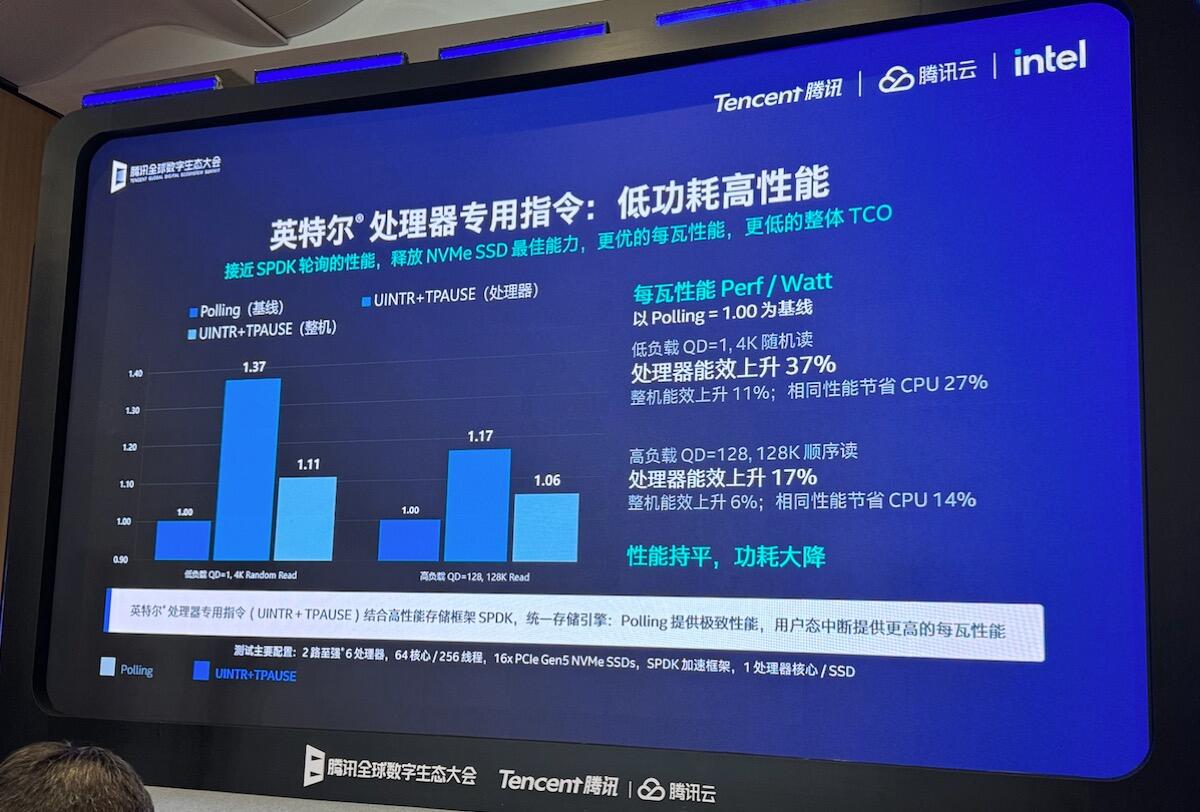
通过这些优化,存储服务器可以根据不同负载选择合适的IO处理方式,在保持高性能的同时减少CPU资源和电力消耗,降低整体运营成本。
以标准化存储平台构建G3.5层KV Cache存储,加快AI基础设施部署
在易部署方面,英特尔给出了基于至强6处理器、16至32块NVMe SSD、RDMA网络和SPDK的软硬件组合,这套组合既可以搭建用于存KV Cache的JBOF,也可作为通用分布式存储的硬件基础。

至强6平台结合QAT、DSA等加速技术,以及软件路径优化,帮助合作伙伴在标准服务器上构建高密度存储节点。这类平台不仅适用于智能体AI的KV Cache存储,也能够支持分布式块存储、对象存储和文件存储等传统企业级存储场景。
测试中,英特尔比较了本地SSD与远程RDMA JBOF的访问延迟,发现基于RDMA的远程访问仅比本地SSD多出约10微秒量级的延迟。该结果说明闪存通过网络扩展容量的同时,性能损失非常小,可以作为G3.5层来用。

结束语
从这次分享可以看到,英特尔正在发挥自身在处理器、硬件加速和存储软件方面的技术积累,让至强6平台在AI存储领域发挥更大的作用。这也意味着CPU在AI基础设施中的价值,正在从传统计算进一步延伸到数据管理和存储加速等领域。
回过头来看,英特尔当年出售NAND闪存业务、终止傲腾产品线,如今面对AI带来的新一轮存储需求,多少让人觉得有些可惜。不过,这次分享也让我们看到,虽然英特尔退出了部分存储硬件业务,但它在存储技术领域的积累并没有中断。
撰文:朱朋博
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表