大模型的竞争,正在从能力边界延伸到落地效率。模型能完成的任务越来越多,企业需要回答的问题也越来越具体:一次业务调用需要多少算力,一项任务应该交给哪个模型,一套AI系统持续运行,又能带来多少可衡量的回报。
当AI从问答、内容生成走向能够规划任务、调用工具和执行流程的智能体,这些问题变得更加复杂。一次任务背后,可能涉及多轮模型推理、多次工具调用,以及对企业数据和知识的持续访问。算力消耗不再只取决于模型大小,也取决于任务如何拆解、上下文如何组织、执行过程是否高效。企业要管理的,已经是从GPU到模型、再到业务执行的整条链路。
这也对AI基础设施提出了新的要求。计算、存储和网络提供了运行基础,但要让智能体真正进入业务,还需要打通模型调度、知识接入、应用开发、权限控制与运行管理,并将资源消耗与业务产出联系起来。GPU是否被充分利用、模型是否选得合适、Agent是否可靠,以及每项任务究竟花了多少钱,开始成为同一套系统需要回答的问题。
9月10日,紫光云发布紫鸾AI操作系统,并将其定位为面向智能体的政企级AI操作系统,旨在为智能体在政企私域环境中的开发、运行和运营提供统一支撑。
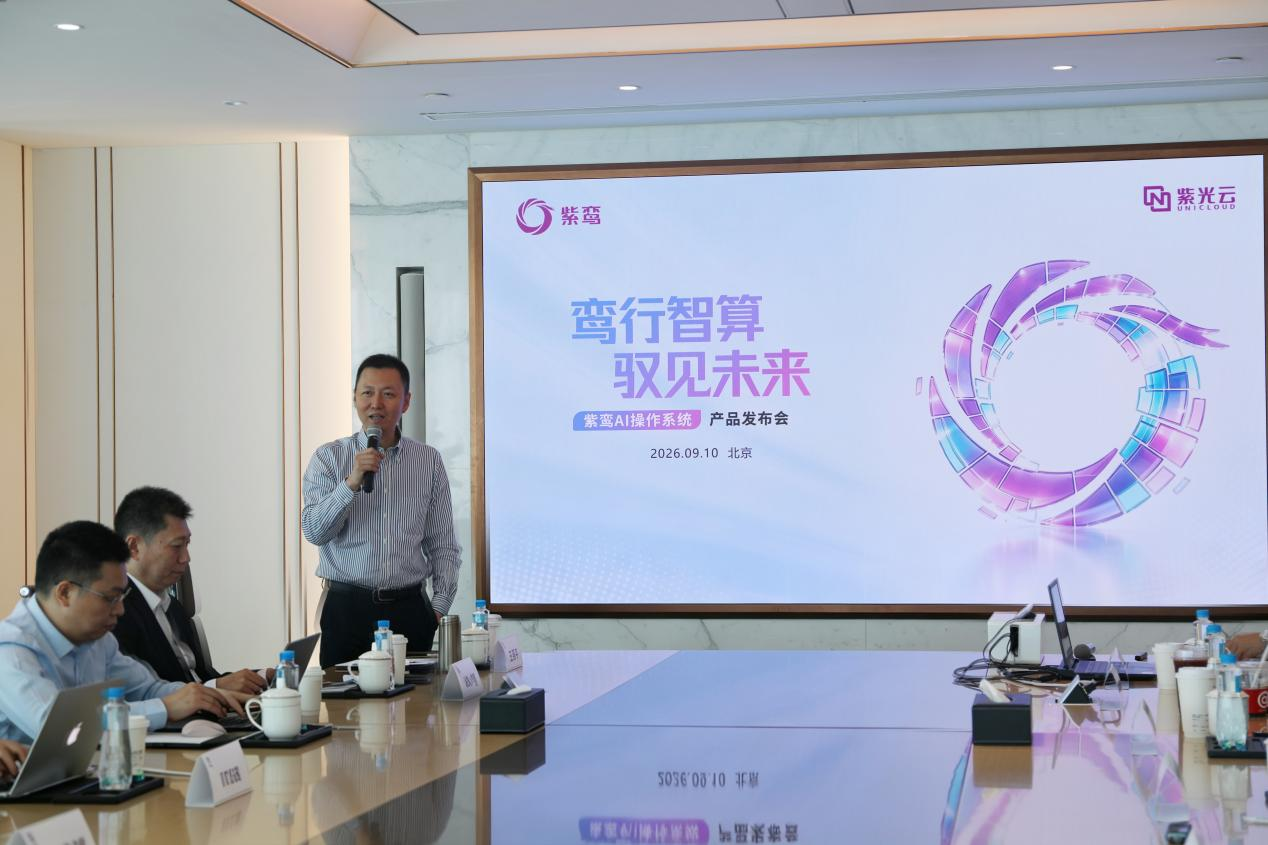 “上面的Agent千千万,我们的目标就是AI操作系统。”紫光云总裁王燕平说道。在他看来,应用与Agent交给生态伙伴,紫光云聚焦的是Agent进入政企私域之后,底层算力、模型、数据、知识、安全和运营的落地与运转。
从“支撑IT”到“承载生产力”,AI底座变了
紫光云首席技术官柳义利在发布会上将AI产业划分为几个阶段:从早期的大模型竞争,到训练、推理和智算中心建设,再到当前逐渐进入AI应用阶段。在这一过程中,智能体成为连接模型能力和业务流程的重要载体。
 这一变化直接改变了企业基础设施的职责。
传统IT系统首先追求稳定,云平台解决的是计算、存储、网络等资源的统一管理;但在智能体进入生产环境后,仅仅保证IT系统“不出故障”已经不够,底座还需要帮助企业“产生生产力”。
柳义利用了一个比较形象的比喻解释这一变化:大模型本身像一匹有动力的马,而Harness、Skill、工具、知识等工程能力,则类似给马套上的缰绳和马具,让它从能够奔跑变成能够拉车。其核心目的,是解决大模型进入真实生产环境后面临的准确性、可预测性和可控性问题。
因此,企业AI真正缺的并不一定是又一个模型。
在紫光云的判断中,政企AI落地至少涉及六个要素:通用大模型、Skill、企业私域知识、工具集、安全以及持续进化能力。单独部署一个开源模型或者大模型一体机,可以解决“模型跑起来”的问题,却未必能够解决“业务跑起来”的问题。
这也是“AI操作系统”概念出现的现实背景。
AI操作系统,管的已经不只是算力
从PC操作系统到云操作系统,再到今天提出的AI操作系统,最大的变化并不在于名称,而在于管理对象。
早期操作系统关注CPU、硬盘、终端等硬件资源;云时代则进一步进入计算、存储、网络的集群化管理;到了AI时代,如果系统仍然只负责这些资源,就很难直接支撑上层AI应用。
紫光云给出的“四层三列”架构,将算力层、模型层、数据知识层和应用使能层纳入统一体系,并叠加安全保障、运营管理和运维管理。其底层覆盖异构GPU集群、算力调度、高性能网络和存储,上层则延伸至模型部署、知识管理、Agent开发以及应用生命周期管理。
 简单说,过去企业买的是一套“资源管理系统”,现在需要管理的是一条从GPU到Agent的完整生产链。
这也解释了为什么紫光云把“六维能力、五维统一”作为产品主线。
六维能力包括算力调度、模型推理、知识体系、应用开发、自主型智能体和Token运营;五维统一则包括底座、用户、入口、运维和运营。其目标不是简单把已有产品摆在一个界面里,而是把原本分散在不同系统中的资源、身份、应用和运营能力拉通。
紫光云将整套能力进一步凝练为统一算力调度、统一模型管理、统一知识体系、统一智能体使能四项统一能力,其上方再以全Token化的运营平台对算力、模型、智能体和知识进行统一计量与拉通。
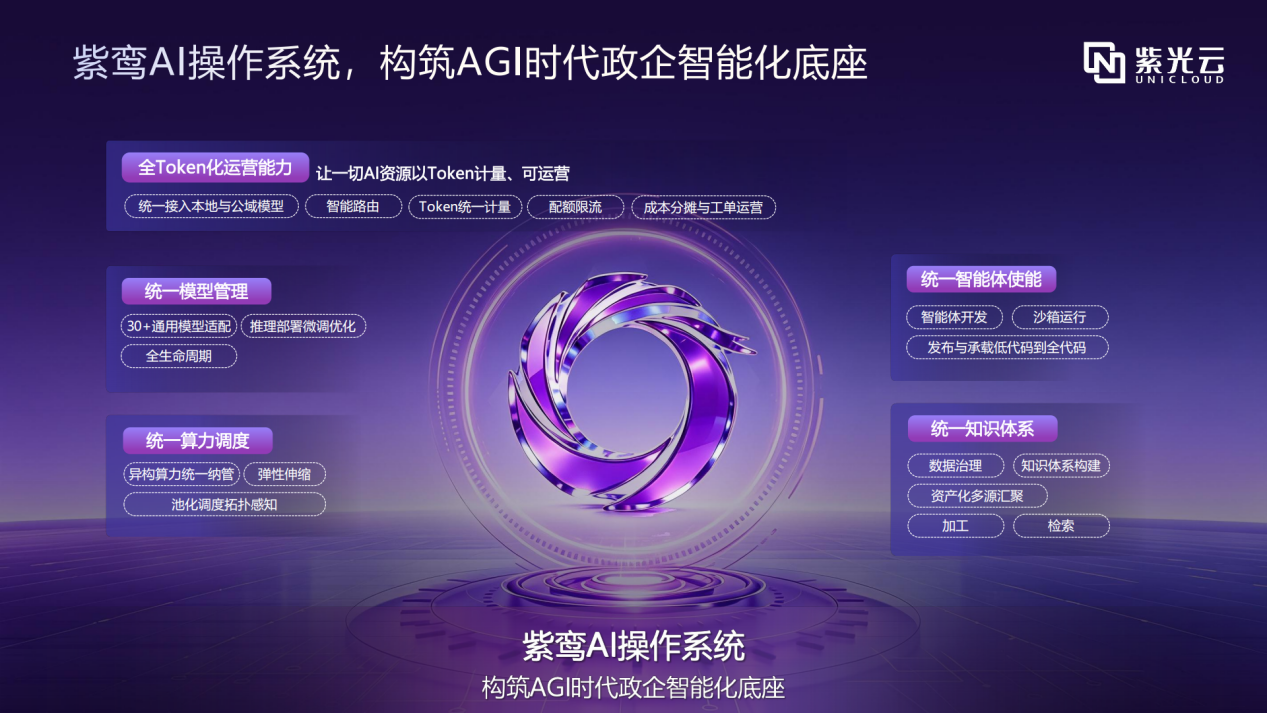 如果说“四层三列”回答的是系统如何构建,“六维能力、五维统一”回答的是操作系统提供什么,那么“四项统一能力+全Token化运营”回答的则是操作系统最终要统一什么。
企业AI真正的难题,是“拼装”之后怎么运营
企业AI落地有一个容易被忽略的问题:系统越复杂,真正进入生产之后的管理成本越高。
比如一家大型企业可能已经采购了不同厂商的GPU,形成多种异构算力集群;研发部门需要使用不同的大模型,部分任务要求调用外部模型,部分数据又必须留在企业内部;模型上线之后,还需要连接企业知识库、业务系统和各种工具。
这种博弈在AI Coding场景里表现得最直接。柳义利在发布会上提到,代码生成必须使用业界顶级大模型,“研发说必须用内外模型是刚需,当然研发喜欢只用外模型,但是企业的管理者说不行,成本高且不安全,你不能把代码都弄给海外”。一边是私有代码和企业知识库不能全部上云,一边是研发团队需要最强的模型保证产出——内外模型的统一接入和智能路由,因此成为企业AI落地绕不开的刚需。
如果这些资源彼此割裂,AI应用越多,管理复杂度就越高。
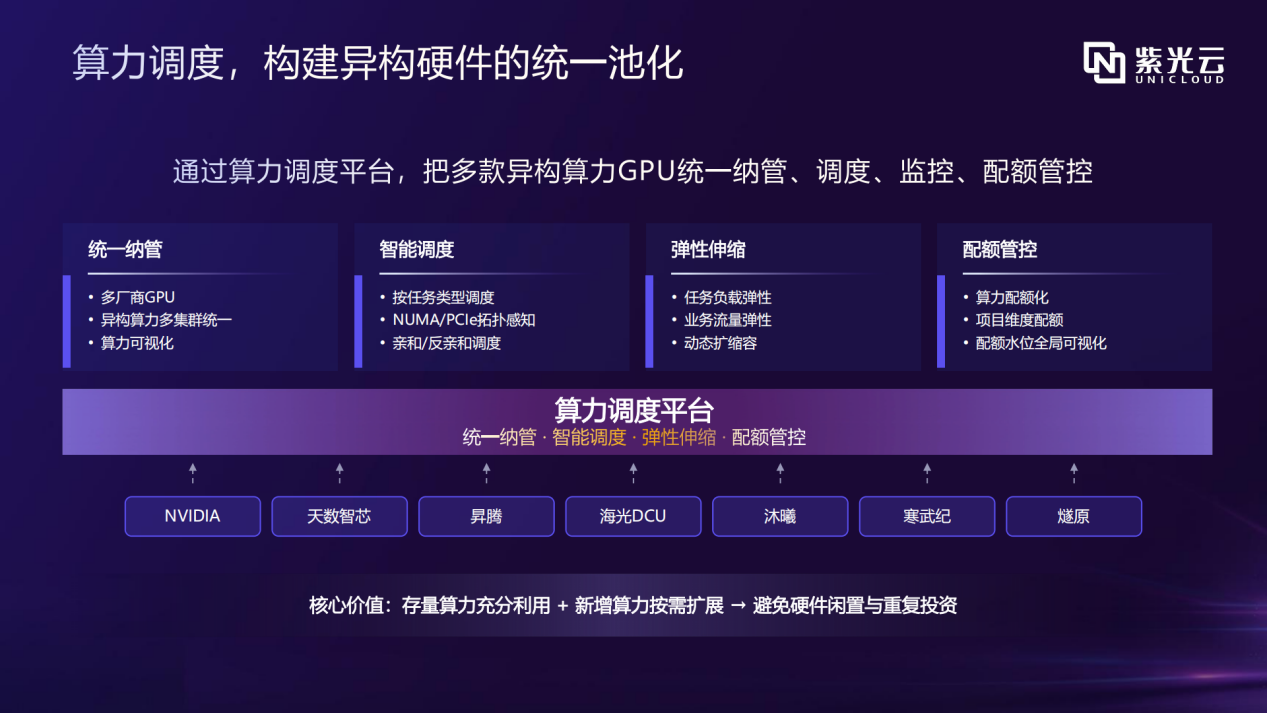
紫鸾AI操作系统把异构算力统一纳管作为底层能力之一,支持不同GPU资源池的统一调度、弹性伸缩和配额控制;模型侧则强调内外模型统一接入和智能路由,在效果、安全与成本之间进行调度。
这一思路的价值在于,把企业原本需要自行完成的“资源拼装”转变成平台侧的统一管理。
更关键的是,紫光云没有把操作系统的边界继续向上延伸到所有行业应用,而是明确提出“应用生态交给伙伴,操作系统留给自己”。也就是说,企业最终使用的办公、生产以及行业Agent,可以由生态伙伴开发,而紫光云负责提供承载这些Agent运行的底座。
这实际上是在回答AI平台市场长期存在的一个问题:平台厂商究竟应该自己做多少应用?
从目前释放的信息看,紫光云选择的是类似云操作系统时代的分工方式——底座标准化,应用生态开放。
Token正在从计费单位变成新的运营对象
如果说算力调度解决的是“资源怎么用”,那么Token运营解决的则是“AI到底用了多少、成本是多少、价值在哪里”。
这一变化尤其值得关注。
传统企业软件通常围绕账号、License、服务器和存储容量计费,而生成式AI出现后,模型调用本身成为一种动态消耗。随着Agent大量调用模型、知识库和工具,单纯统计模型Token已经不足以描述企业AI的真实成本。
紫鸾AI操作系统因此把Token进一步向数据、知识和应用延伸,并提出对模型、数据、知识和应用四类Token进行统筹计量管理。
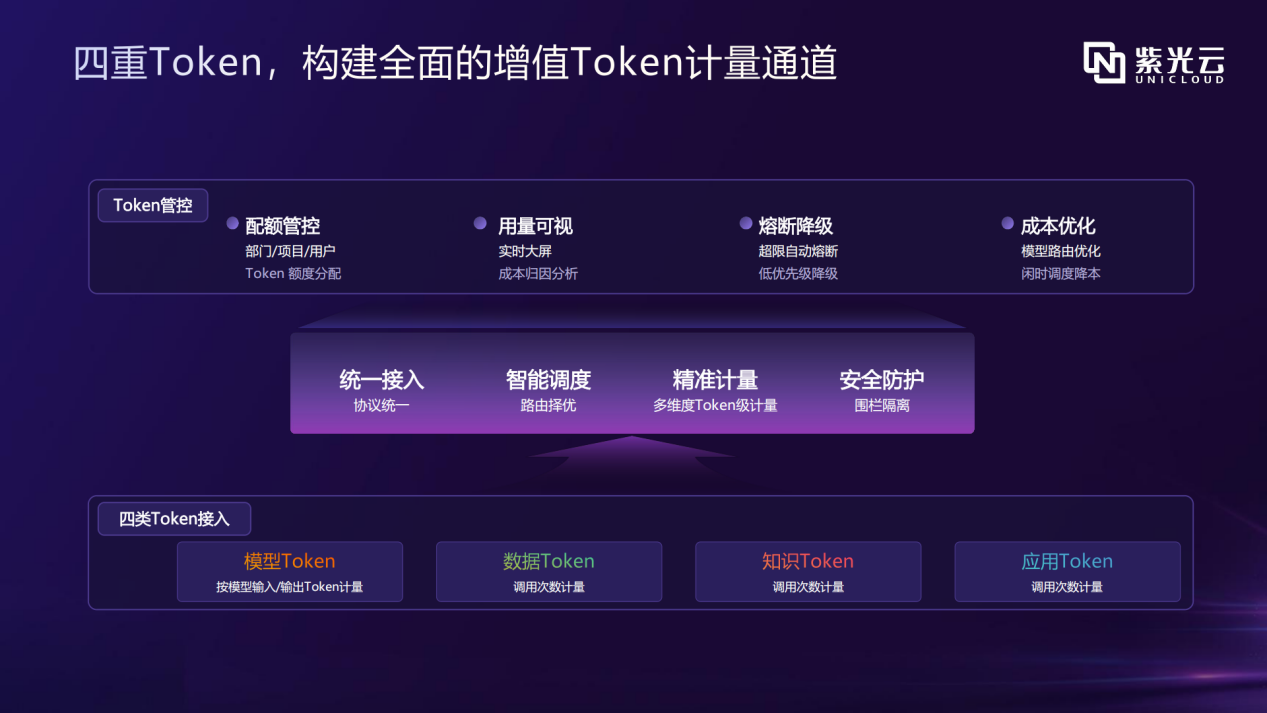
柳义利在发布会上进一步谈到,Token运营并不只是“卖模型”的问题。数据、知识和应用同样可能成为可运营的资产,而且越靠近业务价值,Token所代表的价值可能越高。
这意味着AI平台的运营逻辑正在发生变化。
过去企业关心的是GPU利用率、服务器数量、模型调用次数;未来还需要回答哪个部门用了多少模型、消耗了多少Token、调用了哪些知识和工具、产生了多少业务结果。
从这个角度看,Token更像是AI时代的一种“数字水电表”。
它不只是告诉企业“用了多少”,还需要进一步进入预算、配额、成本归因和业务运营体系。
这套逻辑已经在真实客户身上跑通。柳义利在发布会上以某市卫健委项目为例:紫光云为其搭建算力服务平台、构建全市卫健知识体系,将医疗健康数据从“用不起来的数据体系”转化为可调用的知识体系,并基于Token实现统一计量和管理;卫健委再把底座开放给医疗AI应用厂商,形成产业链孵化的闭环。
从“模型平台”走向“Agent运行环境”
随着Agent在不同平台、业务部门和应用场景中扩张,身份、策略、安全、成本和可观测性开始成为企业规模化部署Agent需要解决的共同问题。因此,“AI操作系统”真正需要回答的并不是一个新的产品名词,而是一个更现实的问题:
当企业拥有越来越多的模型、GPU和Agent之后,谁来负责把这些能力组织起来?
紫鸾AI操作系统给出的答案,是把底座从“资源管理”进一步推向“智能生产环境管理”。
这种面向Agent的转变并不容易理解。王燕平用特斯拉的Cybercab做了一个类比:服务人的车必须有方向盘和刹车,服务Agent的车不需要方向盘和刹车;同样,未来的AI操作系统可能也不需要那么多界面,“因为所有的界面是给人看的,如果给Agent用根本不需要界面,直接底层信息打通就完了”。
这也是紫光云提出“把复杂留给厂商,把简单留给客户”的核心原因。Agent并不是独立存在的聊天窗口,而是需要进入企业已有的数据、知识、流程和生产系统。
这套逻辑要真正成立,还取决于一个外部条件:Agent在B端的落地速度。王燕平判断,随着算力和模型能力逐步成熟,产业竞争重点将进一步转向AI应用,而Agent与AI操作系统将分别成为应用层和底层运行环境的重要载体。到那时,衡量一套AI底座的标准也将随之改变——从“能不能把模型跑起来”,变成“能不能让Agent在企业里真正用起来、管起来、运营起来”。这恰恰是紫光云这场发布会想回答的问题。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表