不用提前扫房间、不用人手把手录动作,仿真生成的身体能力,已在现成硬件上完成实验室验证。

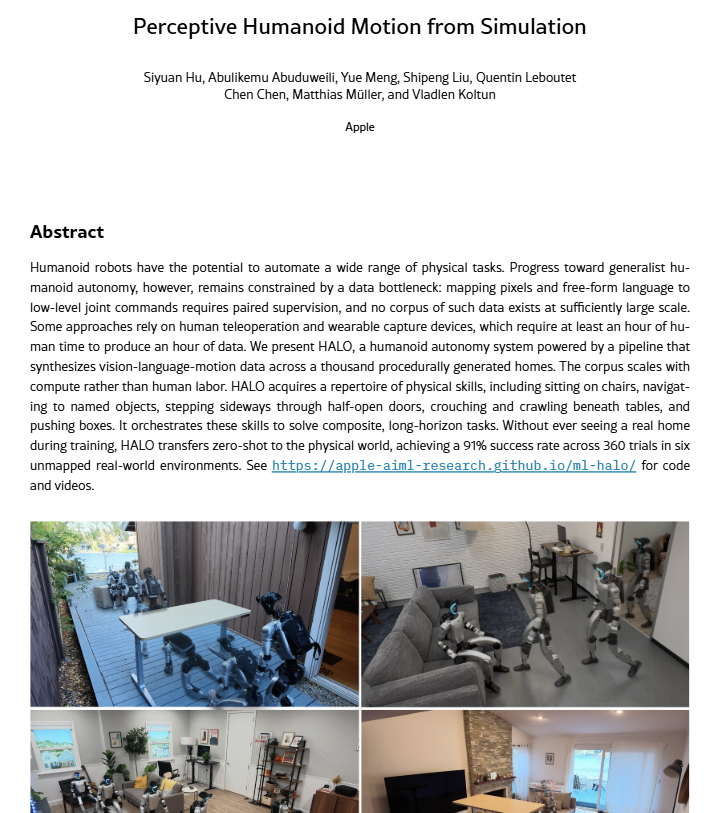
11月4日,苹果机器学习研究团队在arXiv发布论文《Perceptive Humanoid Motion from Simulation》,披露人形机器人自主控制系统HALO(Humanoid Autonomy, Learned in simulation, running Onboard)的设计与实验结果,并将系统部署在宇树科技的G1人形机器人上完成验证。
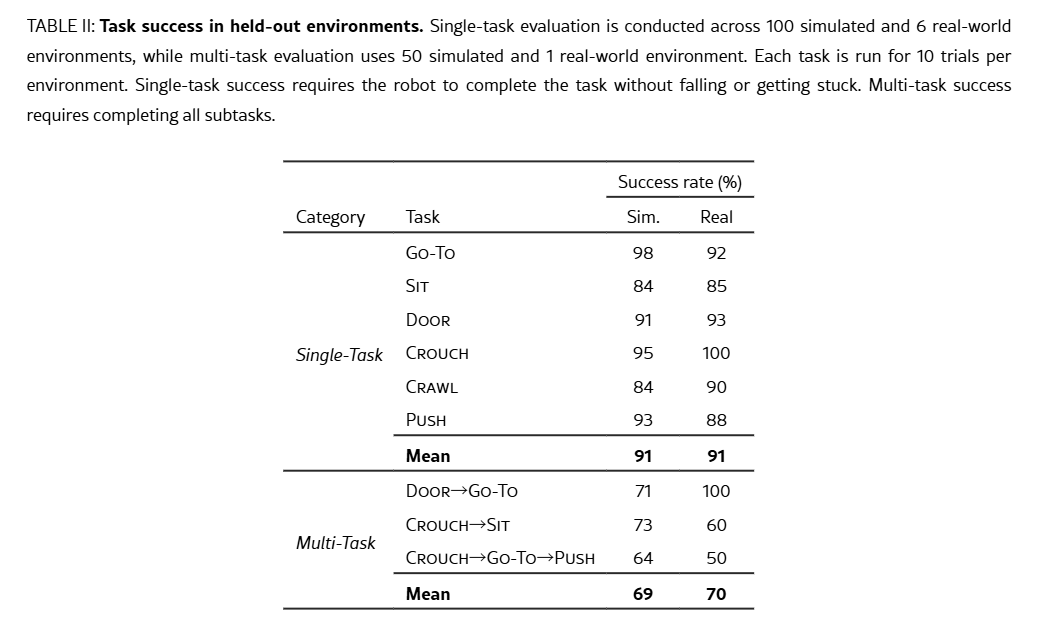
6个训练时从未见过、也未做任何扫描或建图的真实家庭环境,360次单项任务测试,平均成功率91%。论文之外,从数据生成到真机部署的完整代码库同步公开。
很多目光第一反应落在这个数字,以及苹果入局这件事上。但比这两者更底层的是HALO获取训练素材的方式。
过往人形机器人学会坐椅子、推箱子、钻桌底,大多依靠真人远程操控录制动作,或者提前把空间扫描建模,喂给机器一份它“见过”的环境。HALO的训练素材则全部来自程序批量生成的虚拟场景:共生成1200套住宅房间,1178套成功,其中1000套用于训练、178套留作测试,合成296.3小时配对数据,约16.3万个训练片段,250张H100显卡跑了约48小时,数据生成环节全程零人工干预。
没有取用任何真实房间的数据,机器人拿到全新环境后,只靠现场的第一人称视角直接尝试。
这不是一次仿真演示。它指向一个很实在的变化:机器人获取身体技能的原料,可以不再依赖人的采集。
操作员远程遥控机器人,或者佩戴动捕设备、相机阵列一遍遍录制动作,同步采集真实空间数据。样本质量高,贴合真实物理,但慢、贵、场景有限。换一个户型、换一把椅子,之前录的动作就容易失效,得重新采集。论文里有一个扎心的对比:一小时这类数据,至少要投入一小时人力。 在虚拟世界里批量生成房间、家具、障碍物,自动生成视觉、语言、动作三者配对的数据,让机器人在海量不同的“假房间”里练。
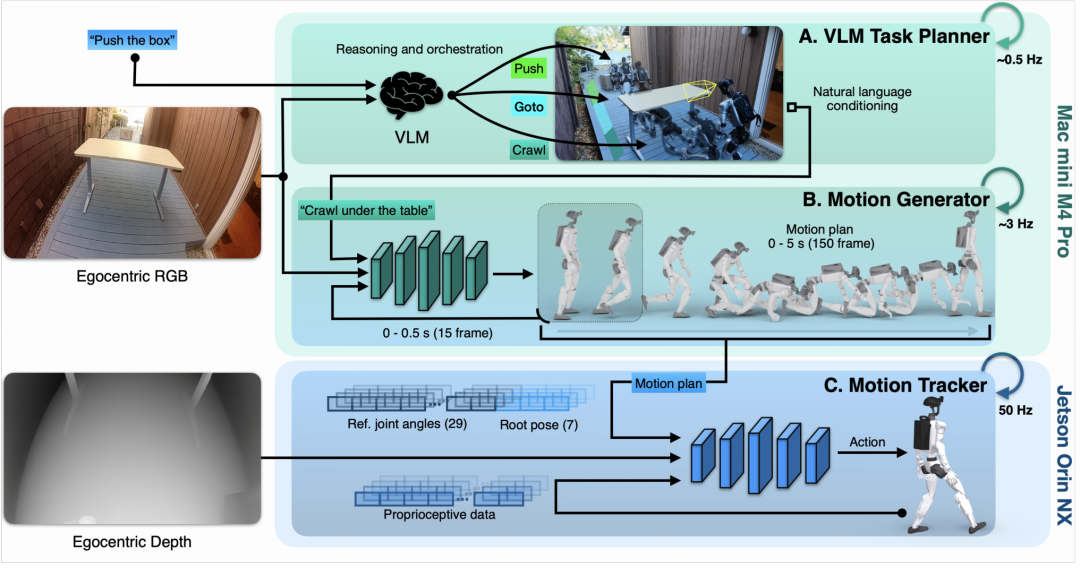
HALO属于后者。它的三层模块,指令理解、动作生成、动作跟踪,本质是配套这套仿真数据管线设计的:上面两层回答“哪把椅子”“接下来干什么”,最下面一层以每秒50次的频率,用机载深度相机和本体感知回答“椅子实际在哪儿”。
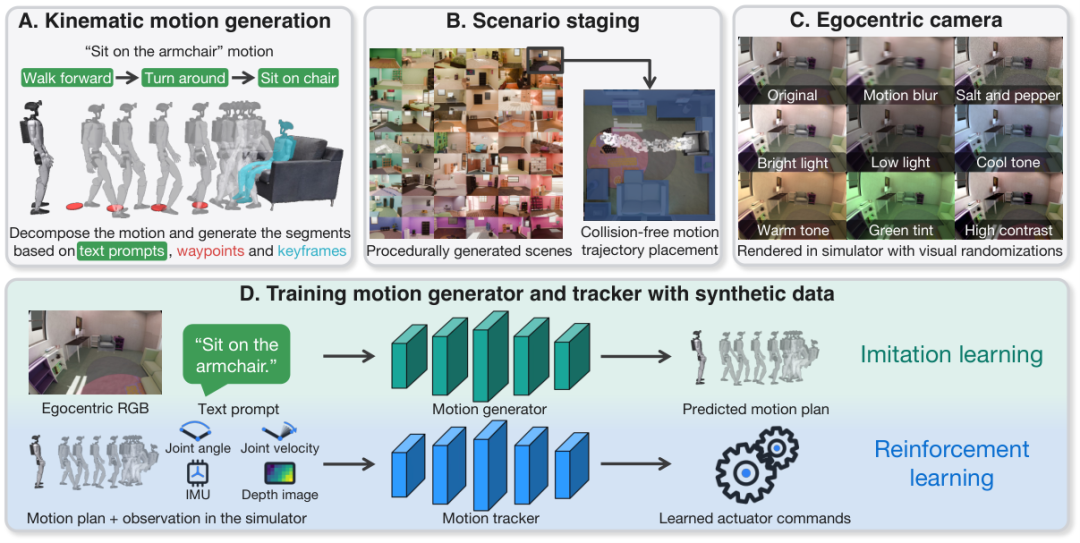
这里有一个容易被略过的工程细节恰好是仿真与现实之间最具体的桥。论文没有直接渲染虚拟画面,而是把每个房间的光照预先烘焙进物体的材质纹理,每个房间耗时约38.5分钟,之后任何标准渲染器都能快速出图。在新视角上,烘焙画面与完整光追渲染的平均偏差约3.8个灰度级,折算成新视角下像素平均偏差约1.5%。
这个1.5%值得记住。它说明仿真和现实之间仍然存在落差,HALO的做法不是消除这个落差,而是用海量多样化的虚拟场景,把落差带来的影响摊薄到可接受的范围。
它换的是过河的路径,不是填平了这条河。

数据生产虽然全自动了,但有两个环节仍然离不开人。
动作由名为KIMODO的运动扩散模型生成,但它只保证运动学上像人,不保证物理上成立,输出的轨迹可能脚滑、穿地、关节超限。系统为每个技能配了一组自动校验,以坐椅子为例,33项硬校验涵盖脚部滑动、离地、关节限位和最终落座高度,每段动作采样16条候选取最优,不过关就重采样,最多六轮。5万个生成的坐椅子片段里,77%通过全部硬校验。 动作的主体由模型生成,但每个技能的首尾关键姿态仍来自人:钻桌底和俯身的关键帧,来自真人手机拍摄的视频,经三维重建后重定向到G1;推箱子接了一段真人动捕录像;落座的最终姿态取自真机G1的关节日志。编排新技能同样需要人工编写提示词、设计关键帧。
换句话说,人从“搬运工”变成了“出题人”,但并没有离开这个流程。论文自己在结论里也写明了这一点。

“苹果用了一台国产机器人”这个角度,新闻性够了,但信息密度不高。
苹果没有从头自研一台人形机器人本体,而是把HALO这套感知与动作系统,直接跑在了市面上现成的G1上,并且分离到了计算架构层面。
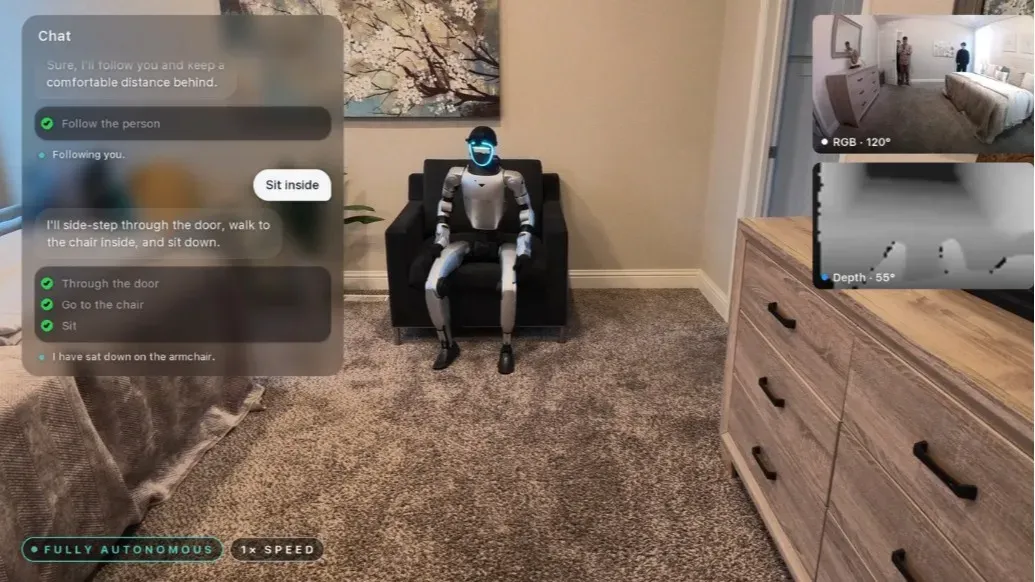
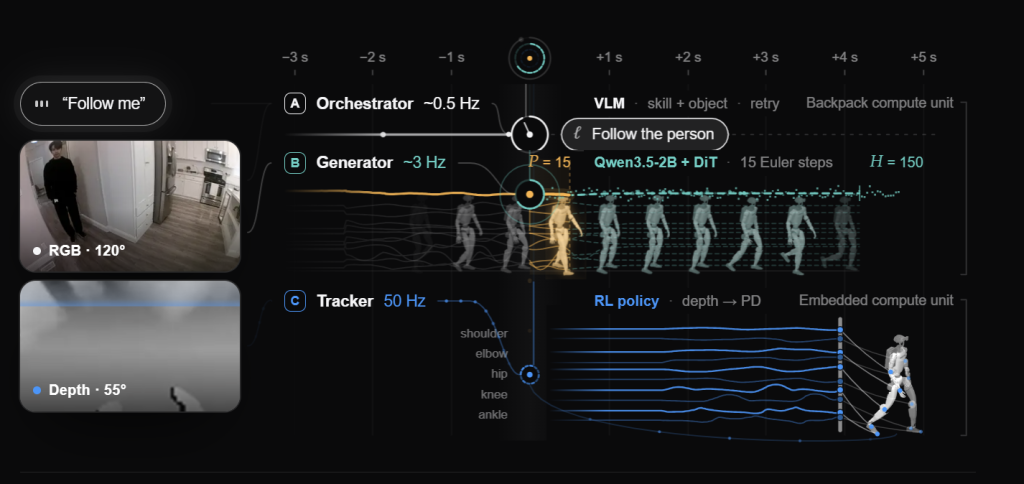
G1只做了两处改装:头部加装一枚广角相机,背部加装一个内置Mac mini M4 Pro的机箱,由机器人内部电源供电。指令编排和动作生成跑在这台消费级芯片上,机器人原厂的Jetson Orin NX负责50赫兹的实时运动跟踪,两台机器异步通信。整套系统不联网也能工作。
这件事释放的信号是未来人形机器人的能力,或许可以拆成两块。一块是硬件本体,包括关节、电机、传感器。另一块是独立的感知动作大脑,负责理解语言、调整身体姿态、适应陌生空间。一套控制系统,有机会作为可移植的软件层,适配不同的硬件。感知与规划跑在消费级算力上,也意味着端侧算力门槛存在下探的可能。
当然,这套移植能成立,也建立在硬件运动能力和传感器配置相对匹配的前提下。可移植,不等于无门槛。
论文里,团队试过微调视觉编码器,微调后机器人反应更快、跟人更顺滑,但只认训练中那一个3D人体模型,换真人就失效;冻结编码器反而能泛化到各种长相的人。最终他们用三维资产生成器造出不同形态的人重新渲染训练数据,才同时保住两者。预训练模型的“常识”和任务数据的“专精”之间存在真实的张力,通用能力从哪来,比看上去微妙。

把局限放在台面上,才知道这条路能走多远。
视觉是唯一的眼睛。系统目前主要靠机器人视角的画面,物体一旦离开视野或被遮挡,策略没有任何信号确认它还在那里,接触密集类任务随之退化。它没有触觉,碰到柔软、会形变的物体,判断会不足。加入触觉感知已被研究团队列为明确的后续方向。
长链条掉得快,且有具体归因。单项任务真实环境平均成功率91%,三种组合任务各测10次,平均回落到70%,其中“俯身过障碍、走向箱子、推箱子”这一串只有50%。论文对失败案例做了拆解:10次测试里5次失败,其中3次是因为钻完桌子后头部朝向偏离了箱子,目标从未进入视野,机器人被房间里其他物体吸引走。
分析指出,组合成功率低于各环节成功率的乘积,说明各环节并不独立,前一个动作的收尾姿态会直接决定后一个动作的起点。研究团队据此提出需要给系统补上“搜索、原地转身”这类恢复行为。
仿真与真实的物理落差有实测数字。真机电机实际只能输出指令刚度的78%到90%,端到端控制延迟约25到30毫秒。团队用开环轨迹拟合参数后,关节跟踪误差下降了62%。还有一个很生动的例子:厚地毯会让脚下沉1到2厘米,只在刚性地面训练的策略会把这误判成倾斜扰动,不停碎步调整,或在原地转身时绊到脚。这些落差没有消失,只是被针对性地建模和随机化训练覆盖掉了。
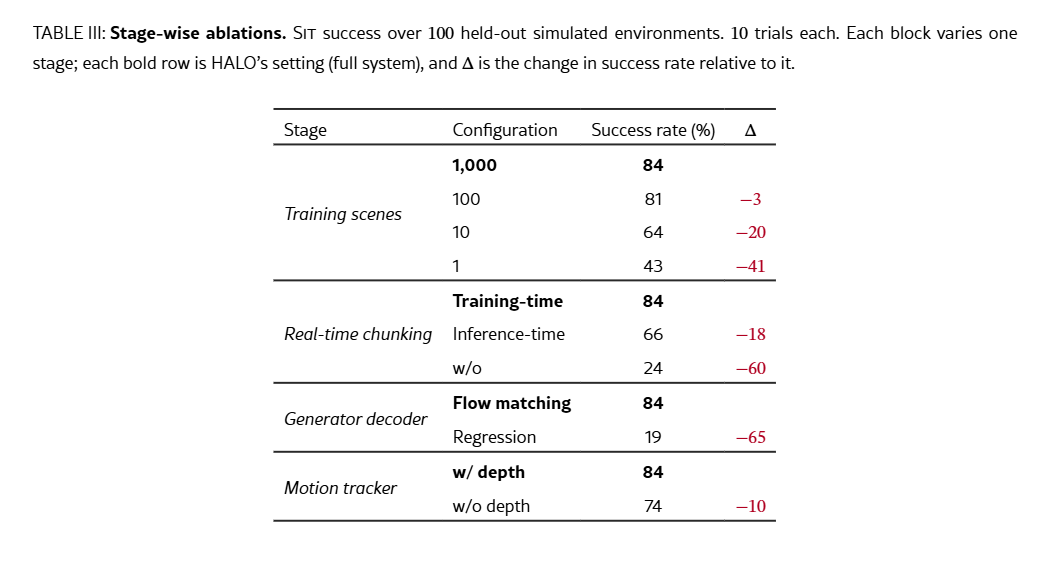
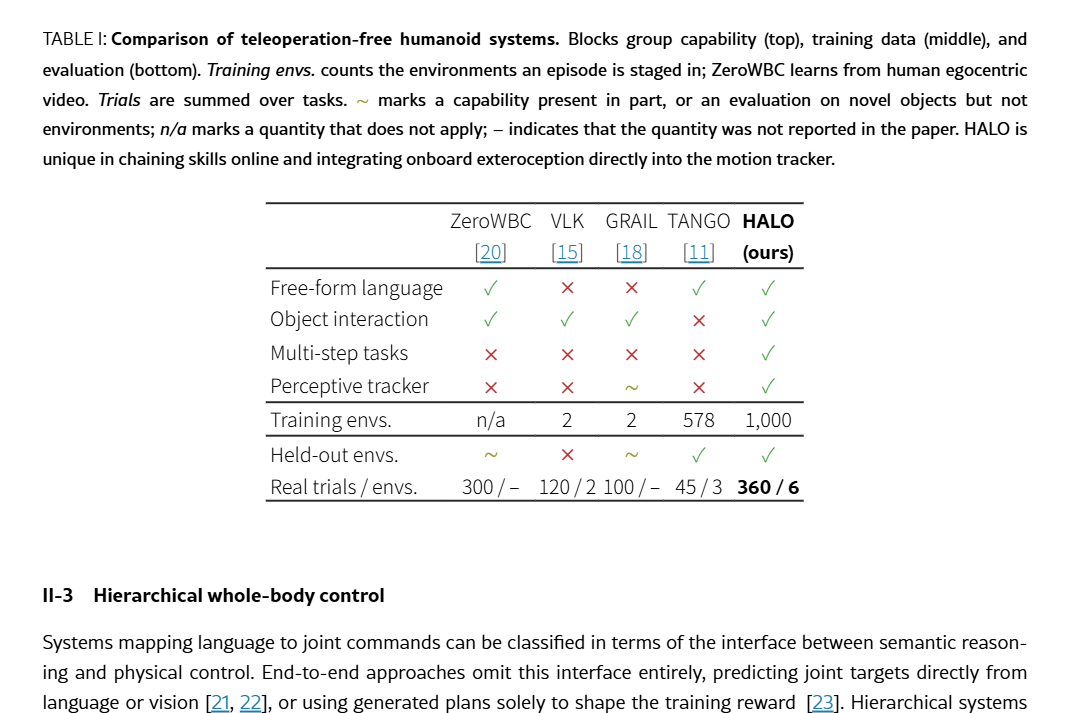
环境多样性比数据量更关键。消融实验显示训练场景从1套增加到100套,成功率从43%升到81%,再增加到1000套,升到84%。作为对照,拿掉深度感知从84%掉到74%,把生成模型换成普通回归模型只剩19%。

行业长期卡在一个很现实的问题上:想让机器人走进千家万户,就得面对千家万户各不相同的布局、家具、光线。不可能每一户都提前扫描,不可能每个动作都人工录制,这条路的天花板肉眼可见。
目前的主流做法是用人的示范做源头,用仿真做放大器。特斯拉Optimus以真人第一人称视频和动捕数据为素材,再用生成式模型把一段示范扩写成上万条合成变体;Figure的模型同样在数十万套仿真环境中训练,但底层仍依赖真人视频数据的预训练。人的示范始终没有从数据管线里离开。
HALO的探索回答了其中一个分支问题:能不能把人的示范也移出去,提前在虚拟世界里把大部分居家场景的基础动作储备好,机器人到了新环境,只靠现场视觉,按需调用、微调姿态?
但编排层目前已验证11项基础子技能,落座、起身、行走、俯身、钻行、推物等,“听懂自由指令”建立在有限技能库上,自由语言只是往这个词表上映射。还有91%证明的是这条管线的可行性,不是通用性本身。
往后,看同类具身智能成果,先问一句,它的动作数据,来自人的录制,还是来自场景的自动生成?如果越来越多的答案是后者,人力采集就不再是唯一的素材来源,“机器人学动作有多快”,将第一次开始取决于算力而不是人手。
苹果此次罕见地同步开源了覆盖数据生成、模型训练到真机部署的完整代码,等于给同行提供了一份可复现的参考实现。方法论是否最优另说,门槛是在下降的。
HALO现在仍是实验室阶段的研究成果,距离日常可用还有很长的距离。遮挡、接触、长任务这几道门槛,目前都还没有跨过去。
它最值得留意的地方不在于91%,而在于它验证了这样一条路径的存在。一套不靠真人动作录制、不靠预先建图的视觉与动作管线,可以在现成的人形硬件上,跑通基础的居家任务。
这是一条还在试错的新路。至于它能不能持续走远,要看它接下来能不能跨过那些还没被写进论文的现实门槛。

参考资料:arXiv预印本2611.06908,苹果机器学习研究团队《Perceptive Humanoid Motion from Simulation》及公开代码库(apple-aiml-research/ml-halo)。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表