8160亿参数模型首次实现在双工作站环境运行,“开放权重+本地推理”的组合开始形成独立的产业路径。
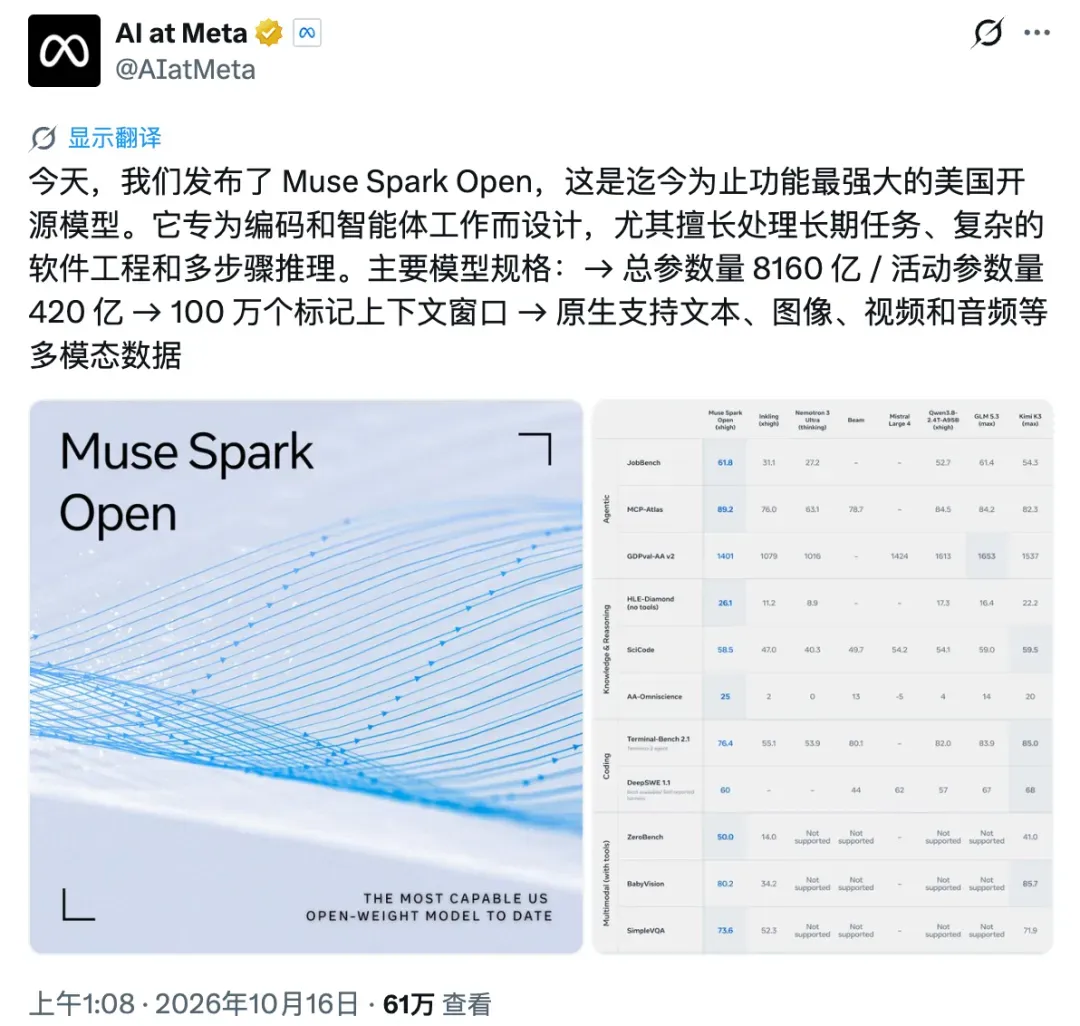
10月15日(美国当地时间),Meta发布开放权重模型Muse Spark Open并同步开放模型权重。该模型总参数量8160亿,采用混合专家(MoE)架构,单次推理激活约420亿参数;上下文窗口100万token;原生支持文本、图像、视频、音频多模态输入,官方定位为面向编码与智能体(Agent)长周期任务。
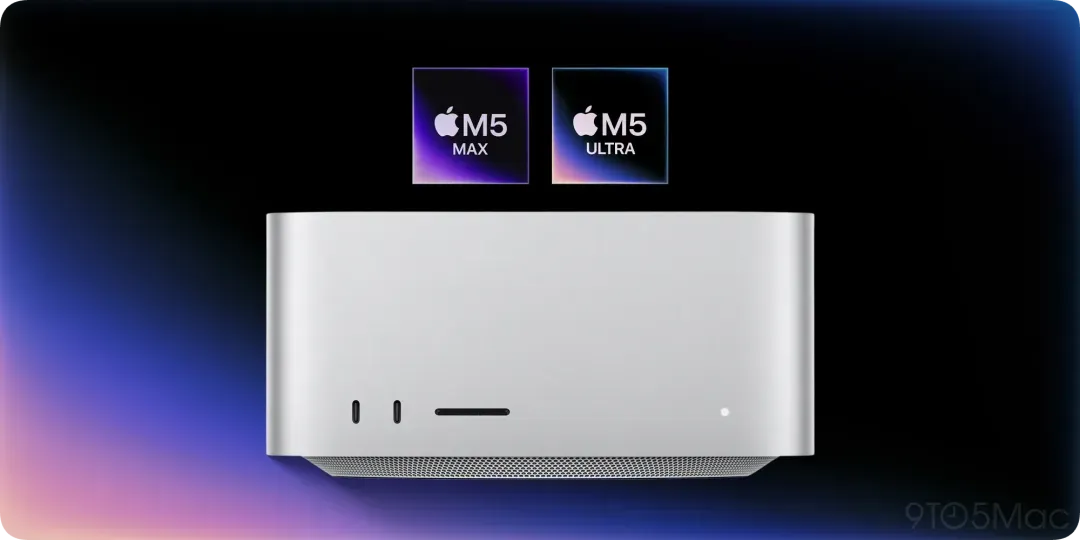
与模型发布同步,Meta与苹果披露了基于MLX框架、M5 Ultra芯片Mac Studio的本地运行方案:两台各配备512GB统一内存的工作站即可承载完整模型,推理过程不经过模型厂商服务器。权重文件已通过Hugging Face以门控(gated)方式开放下载,即提交申请、接受许可证条款后方可获取,并非公开直链下载;权重提供BF16与NVFP4两个版本。
模型定位与开放策略:有限开放权重,分层能力设计
Muse Spark Open是Meta开放权重产品线中迄今规模最大的一款。今年8月,Meta已发布规模较小的Muse Glimmer(30B,Apache 2.0),并承诺后续开放更大模型,此次发布即为兑现。
按官方口径,其能力接近闭源版本Muse Spark 1.3,但仍低于本周早些时候发布的旗舰闭源模型Muse Wonder——开放版本与闭源旗舰之间存在明确的能力分层。
许可证是本次发布中容易被忽略、但实质上更影响采用决策的部分。
Muse Spark Open采用Meta自订的Muse Model License,并非Apache 2.0一类宽松开源许可证,其商业条款的核心约束为:以模型即服务(MaaS)形式对外提供该模型或衍生模型的推理、微调服务,且被许可方及其关联方在任何连续12个月内总营收超过2000万美元,须提前通知Meta并签署单独书面协议。
两点值得注意:
门槛按公司总营收计算,而非该项模型业务的收入;
企业内部使用、科研、非MaaS的商业活动,以及将模型能力嵌入自有产品功能,均不在此限制之列。
此外,许可证要求使用方在产品界面、文档或设置中显著标注“Built with Muse Spark Open”。
综合判断,Meta的策略是有限开放权重。
以免费权重换取生态扩散,同时保留对规模化MaaS经营者的议价入口。2000万美元并非免费商用的普遍上限,而是针对模型服务业务的定向条款。
能力呈现结构性分化,Agent强、编码存在短板
根据Meta官方公布的测评数据,与GLM-5.3、Kimi K3、Qwen3.8等前沿开放权重模型相比,Muse Spark Open的成绩呈现明显的任务维度差异,而非单向度领先。

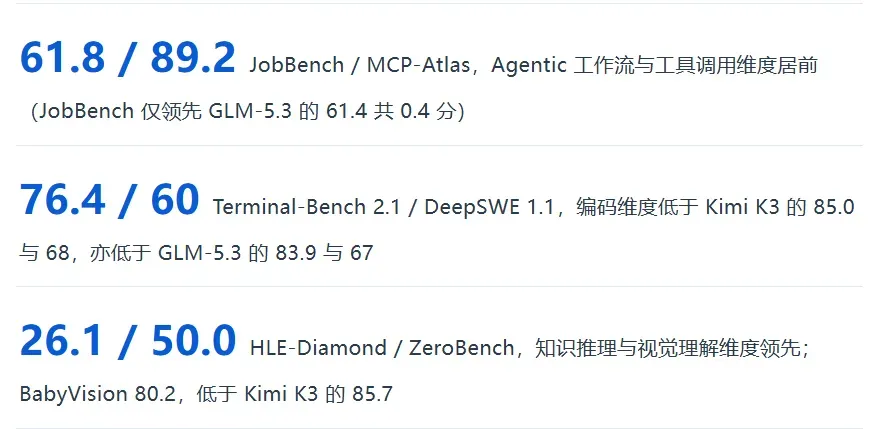
就现有数据可以得出的结论是迄今能力最强的美国开放权重模型这一表述,在Agentic工作流、知识推理与多模态理解维度上成立,在编码任务维度上不成立。
另需说明两点方法学局限。
上述数据均为Meta官方自测,第三方复测结果尚待观察;
Agent类评测基准在行业内长期存在训练数据污染争议,单一榜单分数与真实生产环境中的Agent能力之间不能直接画等号,这一提醒对所有厂商的自测数据同样适用。
量化、统一内存、雷雳RDMA支撑分布式本地推理
将8160亿参数模型部署至桌面环境,核心约束在内存容量与带宽。
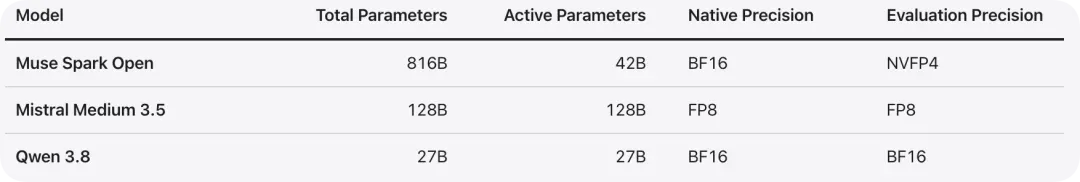
NVFP4版本权重磁盘文件约484GB,压缩后权重本体约493GB,但官方模型卡给出的运行内存下限为700GB(NVFP4)与2TB(BF16),差额来自KV Cache、激活值与运行时开销。换言之,“484GB”是存储体积,不是可运行配置。
这一内存需求源于MoE架构的固有特性。
该模型每层配置256个专家、每token仅路由激活其中8个——计算量取决于激活的420亿参数,但全部8160亿专家权重必须常驻内存池,随时待命被路由调度。这是MoE与稠密模型部署的本质差异,即激活参数小,不等于显存需求小。
在此约束下,两台各512GB统一内存的M5 Ultra Mac Studio(合计约1TB)构成可运行配置的最低组合。
多机协同依赖MLX框架的两种并行策略。
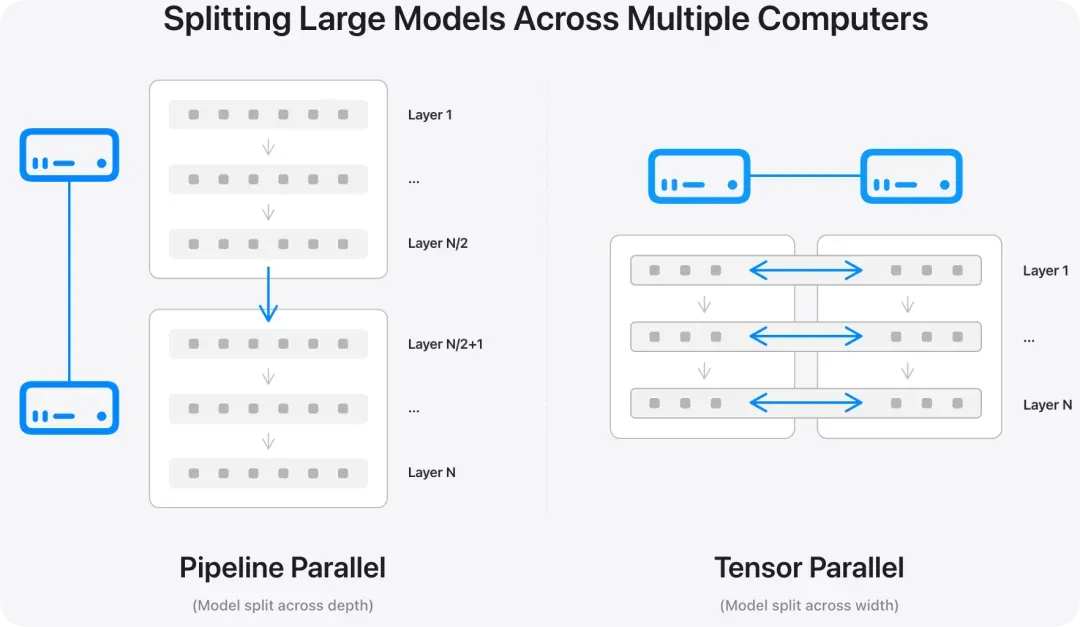
流水线并行按模型层切分、顺序接力,门槛低但存在设备空等,张量并行将单层计算分摊至多机并行执行再汇总,利用率高,但对节点间通信要求苛刻。
苹果采用雷雳5接口上的RDM降低通信延迟,并以双雷雳链路绑定提升带宽。
实测数据:
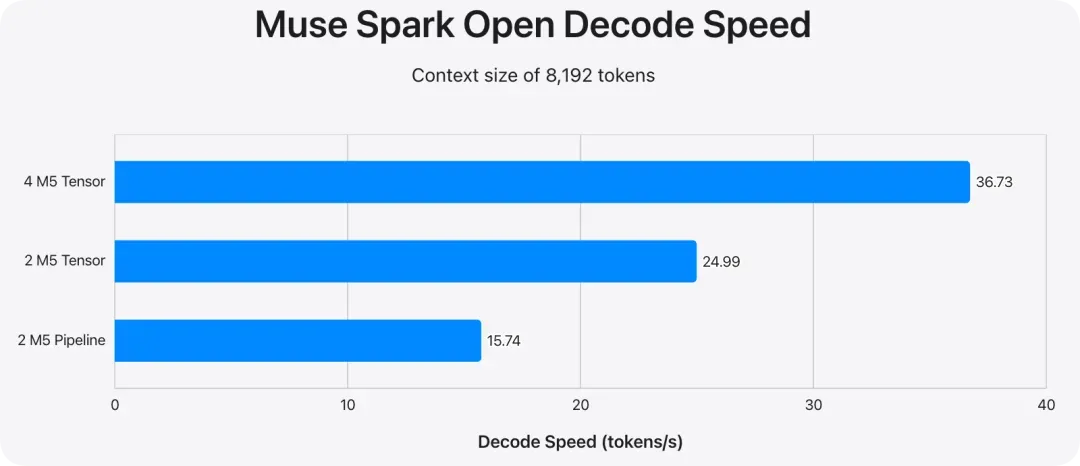
36.73 tokens/s,四机张量并行生成速度(双机流水线并行为15.74)
4.8秒 四机张量并行首token延迟;双机张量并行为8.2秒,双机流水线并行为8.4秒
硬件层面,M5 Ultra将统一内存带宽由M3 Ultra的819GB/s提升至1.2TB/s,GPU引入Neural Accelerators加速矩阵运算;针对Qwen 3.8与Mistral Medium 3.5的单机对照显示,首token延迟最高改善约4.6倍,解码速度提升约1.6倍。

Meta另公布两项完全本地执行的演示。通过Muse Code修改开源iOS应用Ice Cubes并完成构建;端到端驱动DaVinci Resolve完成素材筛选与竖屏裁剪,均属多步骤工具调用的功能性验证。
跨硬件部署是本次发布的另一半事实。Mac方案是桌面本地的验证样本,而非唯一路径。发布当日,SGLang、vLLM、TensorRT-LLM、llama.cpp等主流推理框架完成原生适配,官方给出的数据中心参考配置为4张NVIDIA B300(NVFP4,张量并行+专家并行)或8张(BF16),AMD MI350上,端到端推理性能提升约3%。不具备自建条件的用户,可通过OpenRouter等第三方平台调用API(参考报价约为每百万token输入1.25美元、输出4.25美元),权重亦已上架多家云平台模型市场。
成本与可获得性:高硬件门槛,面向合规敏感的专业用户
512GB版本Mac Studio尚未发售,官方口径为10月底开售。以在售256GB顶配估算,单台已超1万美元;四台256GB组成约1TB内存集群,硬件成本超4万美元。
当前阶段,该方案的适用对象主要为高频调用云端算力的专业开发者与对数据自主有硬性要求的企业。
经济性取决于使用强度。
以第三方API报价为锚点,4万美元约相当于320亿输入token或94亿输出token的云端调用量,推理需求稳定超过这一量级的用户,本地部署的固定成本可被摊薄;数据不出本地的合规与审计便利,则构成另一类难以量化的收益。
苹果Meta联手,验证私有本地Agent新路径
此次合作由曾在苹果任职、现任Meta算力部门联合负责人的Daniel Gross主导推动。据Meta AI负责人Alexandr Wang披露,双方已合作数月,Meta今年早些时候购入数百台Mac,用于超级智能团队的本地AI研究。

双方诉求具有互补性。Meta需要验证其在开放权重赛道的竞争力,苹果需要高规格案例证明Mac平台对本地AI负载的承载能力。
Wang同时明确了一个技术事实。
开发者在本地设备上运行Muse Spark Open时,Meta无法查看或控制其使用内容。这使得“头部实验室的模型能力”与“数据不出本地”首次可在同一部署形态下同时成立。随着AI处理私人文件与企业资料的场景增多,数据控制权的权重正在上升,开放权重恰好为本地部署提供了可行性。
1、云端API,由算力厂商托管、数据上传、按需付费,算力上限高但数据离域;
2、消费端侧模型,单机部署、几十B参数规模,数据保留在本地但能力受限。
双工作站集群构成第三类形态。
专业工作站私有推理集群——小集群规模、固定硬件买断、TB级统一内存、完全离线运行,位于数据中心与个人PC之间,面向企业研发与合规敏感场景。
该形态能否成立,最终取决于开源模型能力的演进速度与本地硬件的性价比曲线。本次发布将这一议题从概念层面推进到了工程验证层面。
开放权重,开启模型能力与数据控制权的解耦
Muse Spark Open的短期影响不宜高估。编码能力尚落后于GLM-5.3与Kimi K3,本地部署的成本门槛也限定了适用人群;其许可证亦非无条件的宽松开源,规模化MaaS经营者仍需与Meta另行议价。
但其长期指向值得关注。模型能力、部署自主权与数据控制权三者开始解耦,开放权重模型由此获得了一条不依赖模型厂商云服务的分发路径。
下一阶段开放模型的竞争,将不仅发生在基准测试榜上,也将发生在部署形态、许可证设计与数据治理方式的层面。本次发布提供的不是一个结论,而是一个可复用的工程样本。
数据来源:Meta 官方博客、Muse Spark Open 模型卡、Apple 技术博客、Hugging Face 模型页;测试数据均为官方自测口径
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表