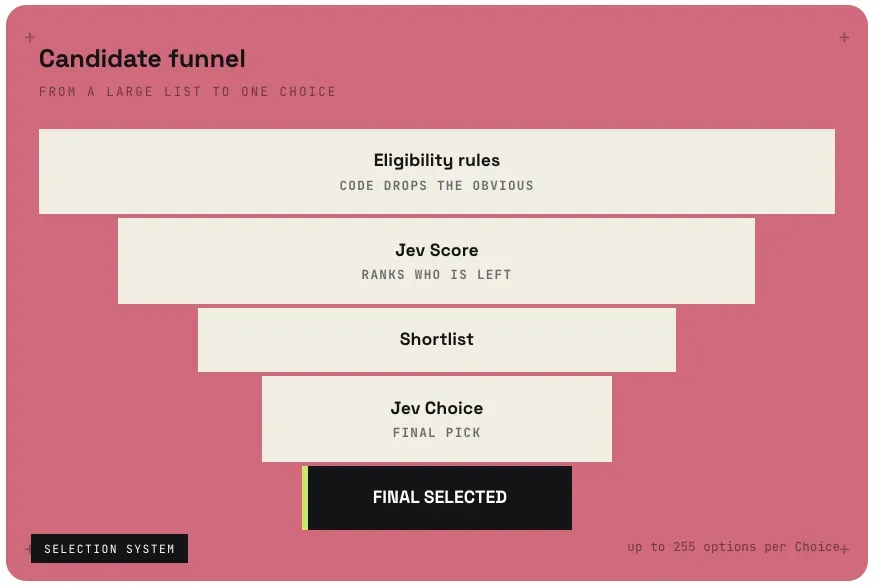
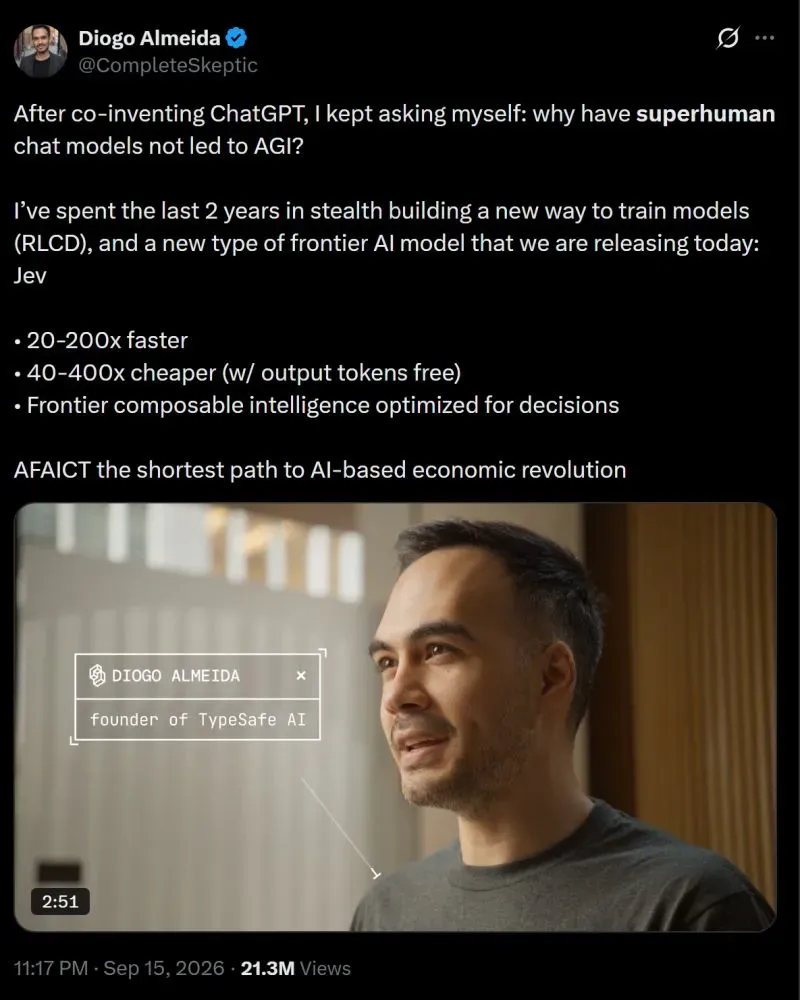
过去一周,TypeSafe AI发布的Jev引发了密集讨论。先把数字摆在桌面上,再谈数字之外的东西。按官方博客基准,Jev在系统一任务上比前沿大模型快20到200倍,成本降低40到400倍,峰值数字为193.6倍与444.6倍,单次决策约0.114秒,定价为输入每百万token0.042美元,输出免费,官方四工作流基准平均一致率约68%。 需要先说明一层限定。 以上全部为厂商自测口径,截至目前没有经过第三方独立复现,RLCD训练方法也尚无公开论文,校准指标没有ECE或Brier Score级别的完整披露。这不是质疑,是阅读一切厂商基准时应有的默认姿势。另外值得一提,官方新闻稿的对外宣传口径其实是最高100倍,比博客基准峰值保守得多,这种区间与上限并存、且宣传低于上限的写法,本身说明厂商对数字的适用边界有自觉。 一个有趣的注脚是命名。Jev取自杰文斯悖论,那个效率提升反而推高总消耗的经济学预言。用在单次决策成本被压到0.00008美元量级的模型身上, 大语言模型的输出空间是词表,几十万量级的离散token,经自回归逐一生成。 Jev的输出空间是三个类型化原语。 Choice从最多255个候选中选一并返回各候选概率与置信度,更大选项集走先独立评分再显式选择的两阶段方案。 Score在2到10个有序等级上返回概率加权的位置。 Noul返回一个是非概率。 所有问题共享同一份输入状态,并行执行,官方称增加问题数量几乎不增加响应时间。 输出空间的坍缩带来三个性质。 其一,没有自回归解码,推理退化为单次前向,这直接解释了70到500毫秒的延迟区间和输出免费这一定价结构,因为不存在输出token可计费。 其二,输出可被程序直接消费,无需从自然语言中二次解析,集成的故障面收窄。 其三,输出可枚举意味着输出可验证,schema层面的格式错误基本不存在。 这里需要澄清厂商零幻觉表述的边界。它在构造层面不会输出预设类型以外的任何内容,大模型常见的JSON截断、格式崩坏在此架构下不会发生。 但这不意味着判断必然正确,它完全可能在合法选项中选中错误答案,高置信度是统计意义上的概率陈述,不能等价为单条请求的正确性。对研究者而言,这类宣传语需要按狭义和广义拆开读。 熟悉模型史的读者会感到眼熟。2018到2020年的NLU主流是给预训练模型接判别式分类头,一个任务一套参数。Jev是这一思想在更高层级上的回归,但不是复刻。 旧式分类头与任务绑定,换任务就要重训,Jev依靠prompt传入评判标准与候选集合,零样本完成此前未见过的决策任务。带回这个范式的,是生成时代积累的后训练方法与校准建模经验。 创始人Diogo Almeida是前OpenAI研究员,参与过RLHF相关工作,这一背景直接体现在训练方法上。官方称为RLCD,Reinforcement Learning for Calibrated Decisions。 重点是校准的位置。 RLHF优化偏好对齐,偏好对齐不蕴含概率校准,一个模型可以在胜率上表现优异,同时对自身答案的把握语焉不详。RLCD把校准写进奖励,目标从选对变成知道自己选对的概率。从决策论看这是更对的优化目标,下游系统做期望效用最大化时需要的是概率输入,而非一段措辞流畅的论证。 官方坦承68%的平均一致率,接近中端大模型水平,与前沿模型有差距,同时强调置信度与实际正确率的匹配。对自动化管线而言,这个性质比多换几个百分点更有价值,瓶颈从来不是已知错误,而是未知错误。 当然,校准指标目前全部来自内部测试集,分布偏移场景下的校准稳定性,是开放问题。 这条线索通向算力讨论的核心。 过去一年推理侧的优化大多围绕自回归解码展开,KV cache管理、连续批处理、投机解码,本质都是为逐token生成的成本结构打补丁。Jev提供的是结构性路径,从计算图上移除解码环节。单次前向意味着延迟方差小、批量行为可预测,这类性质对推理基础设施的意义不亚于峰值速度。 对Agent架构的影响更直接。传统循环中每一步状态跳转都调用生成式模型,输出文本再解析。Jev模式下,意图识别、风险分级、优先级打分可以合并进单次并行请求,高频的状态路由与校验交给决策模型,生成式模型只保留需要深度推理与文本产出的少数环节。LangChain、Pydantic等框架在发布数日即完成集成适配,侧面说明这类负载在真实系统中的普遍性。 需要泼一点冷水的是,输出免费不等于调用零成本。计费锚定在输入状态的长度上,上下文越长单次成本越高,免费的是输出这一侧,不是整个调用。这一定价结构源于输出只是少量结构化数值,没有token流可计量,属于与架构自洽的商业模式设计,但读者不应从中推导出近乎免费的片面结论。 竞争维度也要摆清楚。主流大模型均已支持结构化输出与工具调用,Jev并非结构化输出的唯一来源。核心分野在于,结构化输出是在生成架构上约束采样,Jev是从底层放弃自由文本生成,用输出空间坍缩换取时延、成本与校准三者的同时成立。 边界部分值得比欢呼更长的篇幅。 能力边界的官方自认。 官方文档列出超长无关噪声输入、多层间接推理、高精度数值运算为薄弱场景,且在Wikiracing演示中,官方文档标注对比基线的对手模型被限定为非推理模式,说明基准对比存在不利于竞品的设定。 可解释性短板。 Jev只返回选项与概率,不输出推理过程,在金融、医疗等强监管场景,缺少可审计的决策链路会直接限制落地空间,这是工程现实而非理论瑕疵。 复杂度转移。 输出坍缩不是凭空产生性能,评判标准的措辞、候选集合的设计、置信度阈值与降级路由策略,全部转移到开发者侧。问题定义模糊时,再强的校准也无济于事,系统能力上限的一部分由人写的问题质量决定。 级联架构的错误传导。 前置决策一旦出错,错误将直接进入下游,全链路监控与置信度驱动的熔断机制成为必选项,这是系统研究里的老问题,在新架构下重新变得紧迫。 还留给你开放的研究议程。如何可量化地界定哪些任务属于系统一,而不是依赖开发者直觉。分布漂移发生时校准如何退化。无推理理由的输出如何满足审计合规。级联系统中错误的传播与隔离如何设计。这些问题的答案,将决定系统一模型是一个品类,还是一代过渡形态。 回到开头。Jev的意义不在于性能数字,甚至不在于它本身能做什么,而在于它给两年来的默认架构提供了一个有据可查的反例。全能生成模型第一次出现了有竞争力的分工替代,它不取代大模型,它划定大模型的边界,而边界另一侧,是此前被系统性低估的海量决策负载。 下一代系统的设计命题,已经从“如何造一个更强的模型”,变成如何在同一套基础设施里编排不同输出空间的模型。这是系统研究问题,Jev把它从理论议程拉进了产业议程。这个命名与其说是彩蛋,不如说是厂商自己对需求曲线的预判。
从词表到三个原语
螺旋每转一圈,落点都比上一圈高。
目标函数层面的变化
对推理系统与Agent架构的含义

这是架构路线之争,不是功能有无之争。
边界与开放问题
一个判断
它没有解决复杂推理,但它逼迫行业重新思考一个问题,自动化系统里,哪些环节真正需要生成语言,哪些只需要做出判断。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表