随着AI基础设施的重心逐渐从大模型训练转向规模化推理,如何降低推理成本、提升GPU利用效率,正在成为新的基础设施命题。
其中,KV Cache正在成为一个关键变量。
大模型推理中,Prefill(预填充)阶段会根据输入计算并生成KV Cache,Decode(解码)阶段再基于这些结果逐个Token(词元)生成内容。在多轮对话和Agent场景中,大量上下文可能被重复使用,如果对已有KV Cache进行保存和复用,就可以减少重复计算。
但问题随之而来:KV Cache本身也在快速消耗宝贵的HBM容量。
9月,曙光存储正式发布ParaCache全层级KV Cache高效管理解决方案。曙光分布式存储总经理石静介绍,ParaCache希望解决的,正是KV Cache从GPU HBM不断向CPU内存、SSD乃至分布式存储扩展以后,如何进行统一池化、共享和全局调度的问题。
其提出的概念是——从“存数据”到“存智能”。
从HBM到分布式存储,KV Cache为什么要重新管理?
KV Cache扩展的基本逻辑并不复杂。HBM速度最快、距离GPU最近,但容量有限、成本高。一旦长上下文、多并发请求增加,仅仅将KV Cache保存在HBM中,就会出现显存墙。
由此形成一套KV Cache存储层级:
L1:GPU HBM
L2:CPU DRAM
L3:SSD
L4:分布式存储
当然,拥有这些层级不等于能高效利用它们。石静指出,当前部分KV Cache管理方案主要聚焦单机或者单个推理实例,不同节点之间难以形成真正的共享;与此同时,每一层都有自己的KV Cache数据和元数据,如果缺少全局视角,就很难判断一份KV Cache应该放在哪一层、什么时候迁移、什么时候回迁以及什么时候淘汰。
另一方面,分布式存储虽然天然具备共享和池化能力,但由于分布式锁、数据路径等因素带来的额外时延,过去更多被视作KV Cache的冷数据仓库,难以直接参与高频推理过程。
这也是ParaCache试图解决的第一个问题——不再是增加一个KV Cache存储层,而是把原本分散的多个层级统一管理起来。
ParaCache如何管理四级KV Cache?
ParaCache以曙光ParaStor分布式存储为底座,同时纳入FlashNexus集中式存储,并与主流KV Cache技术和推理框架进行适配,形成覆盖L1至L4的全层级架构。
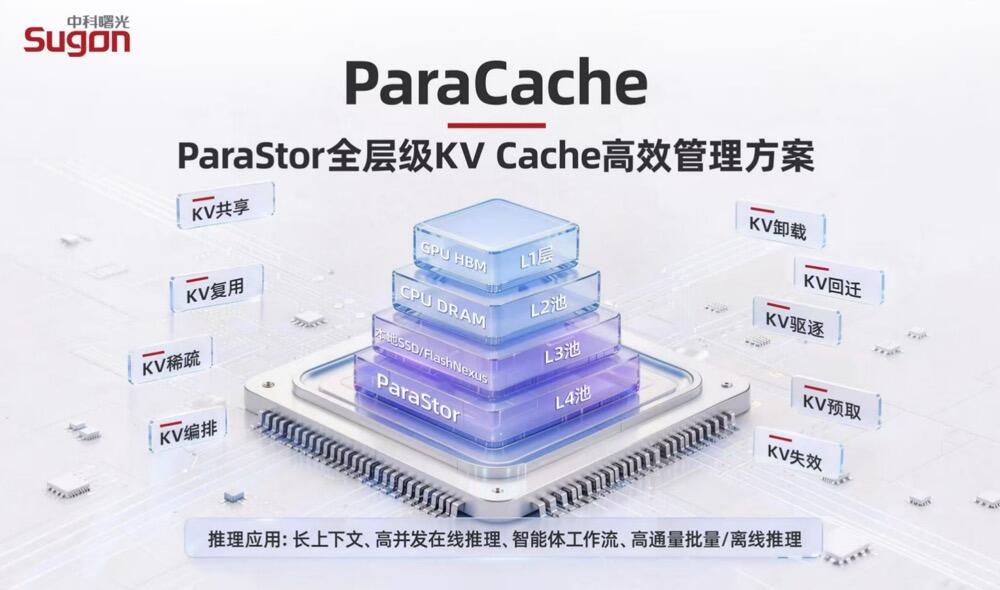
其中一个明显变化出现在L3。传统方案中,L3通常指计算节点内部的Local SSD。而在ParaCache中,除了Local SSD,还首次将曙光集中式存储FlashNexus Neo纳入这一层级。
这样SSD不再必须一台计算节点配一块,多个计算节点可以共享一套集中式FlashNexus SSD资源池。根据曙光公布的测试结果,在部分实际测试场景下,FlashNexus方案在时延、吞吐以及多请求并发等指标上,相比Local SSD可实现约2倍提升。
L4的变化更大。过去分布式存储更多承担最终承接KV Cache的冷数据层,而ParaCache希望让ParaStor直接参与KV Cache在不同层级之间的流动。
例如,一份KV Cache可以从L1卸载到L4,要再次调用时再从L4回迁,并根据访问状态完成后续淘汰。在部分场景下,ParaCache还可以通过XDS数据直通技术,使AI加速卡直接与ParaStor交互,实现L1与L4之间的数据传输,绕过CPU DRAM和本地SSD。
针对传统分布式存储时延较高的问题,ParaStor还进行了KV Cache优化,包括把部分覆盖写方式调整为追加写、轻量化分布式锁,以及在PD分离场景中只传输增量KV Cache,以减少网络和协议开销。
因此,L4在ParaCache中不再只是一个容量兜底层,开始真正参与推理过程中的KV Cache调度。
ParaCache的全局管理特性
ParaCache的另一个重点是KV Cache池化和全局元数据管理。
只有建立统一元数据视图,系统才能知道KV Cache当前位于哪个层级,并进一步决定什么时候卸载、什么时候回迁以及什么时候淘汰,从而打破不同节点和层级之间的管理孤岛。在此基础上,ParaCache还加入了预取机制。
例如,如果推理框架的调度信息显示下一次请求即将使用位于L3或者L4中的某份KV Cache,系统不必等请求真正到达以后再读取,而可以提前把数据移动到需要的层级,从而尽可能将数据传输时间隐藏在推理过程之外。
这意味着ParaCache解决的已经不仅是“KV Cache放在哪里”的问题,而是:KV Cache什么时候放、放在哪、什么时候移动,以及不同GPU和推理实例怎样共享。
对于多轮对话和Agent,这一能力尤其重要。因为这类应用往往具有大量可以重复利用的上下文,KV Cache复用价值远高于一次性的单请求。
为什么还要支持开源生态?
ParaCache在整个架构中,位于推理框架下层,通过与vLLM、SGLang等主流框架进行适配,让已经基于这些框架构建的应用能够接入ParaCache。
对于LMCache,石静也表示,ParaCache并非简单兼容LMCache。LMCache代表的是业界已经出现的一类KV Cache管理思路,而曙光所做的是在此基础上进一步解决跨节点、池化和全层级管理的问题。
ParaCache还会与Mooncake等第三方KV Cache管理软件进行联合适配和开发。上层有不同的大模型、推理框架和PD部署方式,下层又存在HBM、DRAM、SSD和共享存储。ParaCache希望承担的是中间的KV Cache基础设施层,而非替代整个开源推理软件栈。
当前ParaCache能够扩展到多大规模?
ParaCache目前首先瞄准的是GPU节点、超节点以及中大型推理集群。石静透露,从目前应用情况看,ParaCache主要部署在几十到上百台8卡GPU服务器,或数十个超节点组成的推理集群中,上百台规模已经能够稳定扩展。而更大规模集群,例如郑州十万卡集群通常会按照业务划分为不同Pod进行资源池化。
这也更符合当前大规模推理的真实部署方式——KV Cache共享通常先发生在一个推理资源池或Pod内部,再随着业务规模不断扩大。
在性能测试中,曙光选择了匹配实景应用的多轮对话负载。在30K和120K初始上下文基础上连续进行20轮对话时,其测试结果显示,ParaCache可以将TTFT最高降低89%;在多并发场景下,相比仅使用HBM的方案,Token吞吐量最高提升接近26倍。
目前,ParaCache已经进入头部互联网企业在线推理业务进行验证,主要针对TTFT、P95或P99 TTFT和整体吞吐进行KV Cache优化。
从ParaStor到FlashNexus,再到此次推出ParaCache,曙光存储的产品边界也在发生变化,后者开始直接介入推理过程中的数据调度。这或许也是曙光所提出“从存数据到存智能”的真正含义——存储开始从AI推理的后台容量资源,进一步进入算力调度和推理效率优化的核心链路。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表