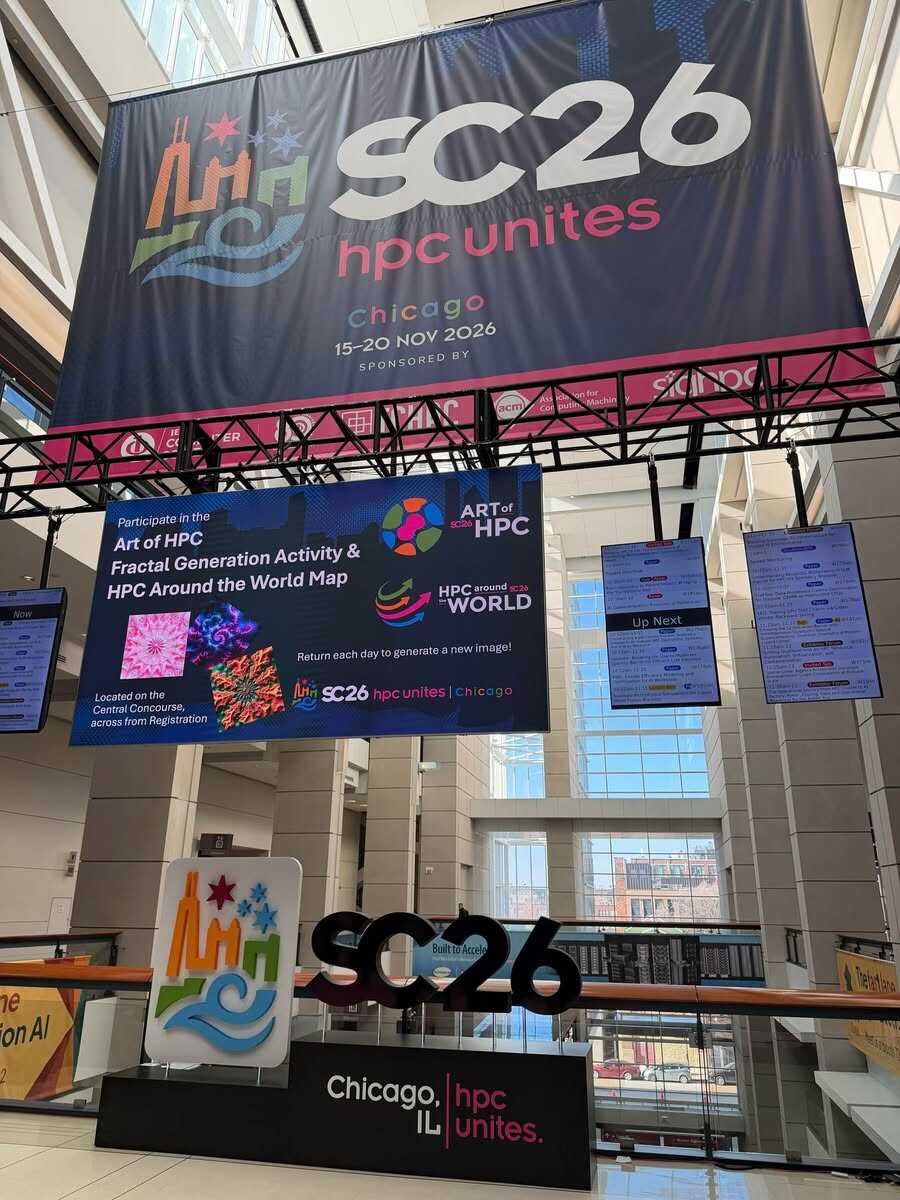
2026年11月15–20日,为期6天的第39届国际高性能计算、网络、存储与分析大会,主题为“HPC Unites”的SC26(Supercomputing 2026)在芝加哥McCormick Place(麦考密克会展中心)召开。官方与第三方统计显示,本届约520家以上展商、1.6万–1.8万名注册者,其中首度参展企业超过50家,来自全球的科研机构、国家实验室、芯片与系统厂商、云服务商和初创企业同场竞技。
三大榜单:TOP500、HPCG、Green500
11月16–17日发布的第67期TOP500是全场最大焦点:中国“灵晟”(LineShine)以2.198EFlops(219.8 PFlops)Linpack实测性能蝉联第一,领先第二名El Capitan(1.809 EFlops)约21%;并以22 PFlops继续占据HPCG榜首,成为“双料冠军”,也是2017年“神威・太湖之光”之后再度由中国系统领跑。第三至第五依次为Frontier(1.353 EFlops)、Aurora(1.012 EFlops)、JUPITER(1.000 EFlops);第六HPC7(0.571 E)、第七微软Azure Eagle(0.561 E)、第八HPC6(0.478 E)、第九Fugaku(0.442 E)、第十Alps(0.434 E)。国别分布上,美国以163台上榜居首,中国18台位列第七。
“灵晟”的技术路线值得单独说明:它首创“在线加速(Online Acceleration)”全CPU超智融合架构——把类似GPU的矩阵加速单元放进CPU内部,配合国产高带宽内存、自研高速互连与全栈软件,实现芯片、网络、存储、系统软件全栈自主可控;已支撑22项千万核级全机规模应用、适配220余款领域应用,基于它的XLSDFT应用成果还入围了2026年ACM戈登贝尔奖。在Green500侧,AMD技术覆盖前十能效系统中的四席、Green500前50中的过半系统,液冷与高密集成成为能效竞争的主战场。
加速器三强:NVIDIA、AMD、Intel
NVIDIA由Ian Buck在11月16日特别演讲开场,核心发布包括:Rubin HPC——Vera Rubin平台中面向科学计算的新GPU,单芯片5万+CUDA核心(约为Hopper的三倍),支持FP64到FP4全精度、新增稀疏数据加速能力,配第七代NVLink,预计2028年上市;Vera CPU平台扩展(德国气候计算中心DKRZ的HLRE-5超算已选用Vera,预计2028年初上线,与TACC的Vera系统形成组合);Nemotron for Science——基于Nemotron 3.5 Super VL开源模型+开放化学数据集+后训练配方,供科研智能体规划实验、跑代码、核结果;此外还有面向科研人员的DGX Spark HPC开发者套件(四节点DGX Spark集群)、与IBM/Fermilab的量子合作,以及CUDA诞生20周年的千余个CUDA-X库生态展示;Vera Rubin平台在MLPerf Training v6.1中横扫全部基准。
AMD主打“开放异构计算+AI for Science”。硬件侧:Instinct MI430X是首款从设计之初就面向“高精度仿真+AI”融合的GPU(现场以47种负载、11个应用评估FP64仿真与原生双精度的取舍);MI355X支撑ORNL的Lux AI集群(TOP500第14、220.79 PFlops);第六代EPYC(代号Venice)提供最高1.6 TB/s内存带宽、PCIe Gen6、最高5.3 GHz,后续Venice-X将带来每路1152 MB L3的缓存敏感型优势;网络侧AMD AI NIC让同一张以太网同时承载大规模AI训练与MPI科学仿真(Lux的scale-out即由其提供)。软件侧最亮眼的是开源AMD HPC Assistant——一个“智能体HPC助手”,从作业提交、GPU profiling到能耗可视化与kernel优化,先在LUMI落地、正扩展到Frontier。全球部署还包括芬兰LUMI-AI(MI430X+六代EPYC)、英国Dawn扩容(MI355X,Dell集成)、法国首台E级超算Alice Recoque(与Eviden共建)。
Intel首次披露下一代至强Diamond Rapids的完整参数:最多256个性能核(4个计算单元块)、统一内存Fabric带宽1.6 TB/s、最高1.28 GB LLC、16通道DDR5(8000 MT/s)并支持MRDIMM 12800 MT/s、128条PCIe Gen6与CXL 3.0/UPI3、8条PCIe Gen4,安全侧含TDX/TPM/IXG等。同期公布GPU D270细节,定位以AI推理为主、兼顾传统HPC,并给出与NVIDIA RTX PRO 6000 Blackwell服务器版的对比基准。这显示Intel在“CPU高核密度+大缓存”与“推理型加速器”两条线上同时补位。
系统集成商:从“卖机器”到“卖AI工厂”
HPE的主角是ORNL的Lux——为美国能源部Genesis Mission打造的首个专用AI系统,TOP500新晋第14,220.79 PFlops,采用直液冷ProLiant Compute XD685+AMD MI355X/EPYC/Pensando DPU+HPE Juniper QFX 800G交换机(该实验室首次部署HPE网络方案,支持开放以太网、负载均衡与拥塞管理),年度350万节点小时中一半供Genesis Mission使用;HPE另投入3700万美元实物资源。HPE同时预告Discovery——Frontier的后继下一代超算延续Cray EX血统。
戴尔把“从第一台服务器到整机柜”讲成一条路径:PowerEdge M8825风冷高密AMD平台(单节点最高512核/1024线程)、AMD Helios机架级方案(72颗MI455X,最高2.9 EFlops)、工厂预制的PowerRack、第18代PowerEdge(较上代最高提升70%、13:1整合比),以及已发布的XE8812(NVIDIA Vera Rubin NVL4,单柜最高144 GPU、300kW+、CPU/GPU全直液冷)。数据侧扩展Dell AI Data Platform(让数据“为智能体就绪”)与Agentic AI Platform,现场还设NemoClaw Lab,40分钟在DGX Spark类设备上搭出一个可用AIAgent。
Lenovo以“AI与HPC融合”为主线:基于前一周发布的第六代EPYC SP7的ThinkSystem SR755、Dynamic Partitioning(两台双路机可动态切成单路再切回)、Neptune海神液冷、高性能存储DE6800/DE6500,并把AI Factory服务扩展到“吉瓦级”部署。Supermicro带来H15平台(六代EPYC 9006:最高多33%核心、2倍PCIe带宽、每路1.6 TB/s内存带宽)及与IBM、NVIDIA合作的KV Cache方案(Petascale存储服务器+IBM Storage Scale+NVIDIA Dynamo+Spectrum-X以太网)。
网络与互连:开放以太网成为共识
Broadcom主张“一张以太网打通scale-up /scale-out/scale-across”:Tomahawk 6、Tomahawk Ultra、Jericho 4交换机,Thor Ultra 800G NIC,以及TH6-Davisson共封装光学(CPO);展台剧场联合AMD、Arista、Dell、Google、HPE、Meta、Microsoft、Nokia等做20余场技术演讲,另有Aria Networks、Micas、Accton/IP Infusion的落地演示。Keysight用8个演示回答“如何验证”:64×800GE混合集合通信仿真(2×2 CLOS)、ESUN/Ultra Ethernet多厂商scale-up互通(100G/200G SerDes下的LLR与CBFC)、UALink一致性测试、2U平台内8端口1.6T以太网测试与MoE仿真、1.6T光/有源铜缆的BER/FEC验证、“从电网到芯片”的供电链路测试。光纤侧首展商Crosstown Fiber独家为SCinet提供全部对外网络所需的地下光纤,并部署“量子通信就绪”基础设施。
量子与HPC的“合流”:59家展商涉量子
SC22时只有7家展商提到量子,SC26已达59家,量子不再是独立展区,而是插进HPC工作流。IBM与NVIDIA把开源QRMI与Slurm的HRES打通,让作业调度器“看得见”QPU资源;与RIKEN、NVIDIA用GPU超算ROQUO把铁硫簇的SQD计算逼到距DMRG仅4.3 millihartree(比此前SQD结果近79倍);与Fermilab共建模块化量子协同设计平台;与AMD发布开源Pelagos(在GPU上以数十亿错误模式检验纠错解码器,1→8卡端到端吞吐6.23倍);Cleveland Clinic+RIKEN+IBM以量子-经典混合模拟12,635原子蛋白-配体复合物,入围戈登贝尔奖。首展商MemQ(芝加哥本地)带来量子网络接口控制器、量子存储模块与量子控制系统,主打“不同量子比特类型接入原生量子网络、分布式纠缠规模化”。Classiq则从应用层切入,用Qmod语言+设计自动化做“一次构建、多处部署”的混合量子-HPC软件。
学术侧:keynote、奖项与议程热点
本届keynote由Caltech的Animashree Anandkumar(Anima)主讲,主题是“让AI理解物理世界以加速发现”——她正是GenSLMs与NVIDIA Earth-2路线的重要推动者。2026 Seymour Cray计算工程奖授予Thomas Sterling(UT Austin/TACC),表彰其共同开创Beowulf/Linux商用集群计算并全球扩散;Test of Time奖颁给Nathan Bell与Michael Garland的GPU稀疏计算工作。技术议程上,从“CUDA 20年”“AI超算:演进还是革命”“zettascale时代GPU之外的加速器”,到“把量子真正吸收进HPC生态”“智能体工作流”“机密计算”“HPC人才与可持续性”,20场panel基本覆盖了当下争议焦点;SC Illuminations、SCC学生集群竞赛、首设的Regional Tech Hub也把“区域产业+AI/量子落地”搬上台面。
五大技术判断
1.“超智融合”成为系统设计的第一原则:不再是“HPC集群+旁边放一堆GPU”,而是CPU内生矩阵加速(灵晟)、GPU兼顾FP64/FP4(Rubin HPC、MI430X)、机柜级统一内存与互连(Helios、NVL144)三条路线同时收敛。
2. 智能体(Agent)正式进入科学栈:NVIDIA Nemotron for Science、AMD HPC Assistant、Dell Agentic AI Platform、IBM的Slurm-QPU调度,都是把“AI会调工具、会跑实验”当作基础设施需求来设计。
3. 网络标准战进入落地年:Ultra Ethernet、ESUN、UALink、800G/1.6T、CPO,验证工具(Keysight)和交换机(Broadcom/Juniper)已能给出多厂商互通证据,闭源私有互连的空间被压缩。
4. 能效与液冷即成本:直液冷(HPE XD685、Dell XE8812、Lenovo Neptune)、300kW+机柜、Green500排名,已经和采购决策直接挂钩。
5. 量子从“展台噱头”变为“工作流组件”:QRMI/HRES、Pelagos、openQSE、SQD逼近DMRG,说明混合量子-经典的计算范式正在形成可复用的软件接口。【综合自网络】
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表