随着智能体AI加速落地,传统算力评估方式正面临挑战。过去,业界主要以每秒Token数、每瓦Token数和每美元Token数衡量AI性能,而智能体AI要求生成的Token在真实世界中切实应用,评估视角随之从Token本身转向智能体及其执行的任务。
在这一背景下,Arm在近期发布的《智能体AI时代如何定义CPU与软件栈性能》的白皮书中提出了一套面向智能体AI的CPU性能评估思路并于10月22日举行线上媒体说明会进行诠释,帮助业界更好地衡量智能体AI时代的CPU性能。
智能体AI重塑CPU性能评估标准
智能体AI的应用场景正快速分化。在媒体说明会上,Arm云AI产品解决方案总监Ravi Malhotra介绍说,Arm将其归纳为五类:软件工程、企业自动化、科学研究、个人助理与机器人技术。软件开发中,编译与测试代码耗时较长、消耗大量CPU周期,单个智能体性能因此格外重要;个人助理或企业运营的单次操作虽短,但操作数量庞大,对吞吐量与运行效率提出更高要求。这意味着没有两个智能体是完全一样的。
为回应这种多样性,Arm在白皮书中提出两部分方法论。一是从组件角度出发的基准测试,通过测试Web服务器、数据库或模型服务的开销,精确了解单个组件的表现,却无法反映组件在智能体工作流中如何连接与协同,二则是端到端智能体基准测试,为评估完整工作流提供代表性参照。
两类基准对CPU的考察各有侧重。工具调用类组件关注每周期指令数、输入输出与并发;编排环节强调CPU的并发与利用率;推理与规划中CPU充当头节点,重点考察分支预测、缓存、内存延迟与内存带宽等单线程能力。端到端测试则更关注可扩展性与并发性,并需在吞吐量与服务等级协议之间取得平衡。
这正是Arm强调的持续性能。
CPU重回C位,机架级视角成关键
智能体时代的算力分工,重新把CPU推向核心位置。Ravi Malhotra指出,在智能体AI中,CPU的关键任务可分为三类:一是把已生成的Token转化为行动,如构建与测试代码、访问Web服务器和数据库,二是承载Token生成所需的数据,将其存入KV Cache和向量数据库并尽快传给加速器,三是编排与沙箱隔离,把Token生成与行动连接成完整的端到端流程。
由此,评估视角也需从单芯片转向整个机架。Ravi Malhotra解释说,客户在数据中心部署和使用的是整个机架,而非单颗CPU。若只做CPU间的两两对比,就无法衡量能效、内存利用效率、服务器成本与功耗,以及单机架能容纳多少台服务器或多少颗CPU。因此,衡量标准应落在机架层面实际交付的性能上。
这一视角的转变直接关系到用户选型。Arm CPU更注重性能、规模与效率之间的平衡,而x86架构或其他CPU往往倾向于强调其中某一项参数。对企业而言,与其纠结于纸面规格,不如依据自身用例所在的原型类别,选取相应的端到端智能体基准与组件来评估平台。
需要说明的是,Arm强调以均衡取胜。由于不存在完全相同的两个智能体应用,为每个用例选择不同的CPU并非可扩展的模式。在大部分市场,真正需要的是能在性能、可扩展性和效率之间取得平衡的选择,这也是Arm AGI CPU试图提供的价值。
Arm AGI CPU对比x86的效率优势
为验证这一思路,Arm与独立技术分析机构Signal65合作,后者发布报告,对比Arm AGI CPU与某x86厂商新一代服务器处理器在智能体工作负载上的表现。研究重点关注Arm AGI CPU带来的效率、可扩展性与性能平衡。
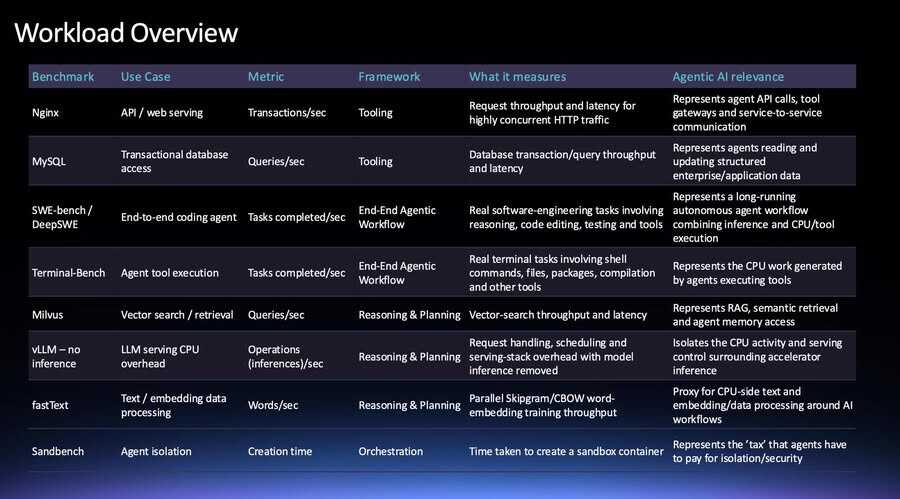
报告结果显示,在相同功耗预算下,Arm AGI CPU的每机架性能约为该x86芯片的1.99倍。细分来看,工具调用类工作负载的每机架性能达到对手的1.7倍,推理与规划类应用(如向量数据库、缓存)达到2.2倍,单纯看端到端智能体基准则为2倍。
这一优势源于性能与效率的组合。报告指出,平均而言,Arm AGI CPU在每核及CPU SoC层面的性能都高出对比平台约20%;由于每核功耗更低,相同机架功耗预算下可部署更多核心,二者叠加便带来约2倍的机架级优势。此外,在沙箱创建开销的测试中,Arm AGI CPU的成本也远低于该x86芯片。
Arm正以多种产品形态推向市场,包括1OU双节点与2U2P两款服务器参考设计,超微电脑、联想、华擎科技等伙伴提供面向不同用例的量产平台,机架层面则涵盖风冷与液冷方案,覆盖19英寸与Open Rack双宽规格。
CPU与GPU/DPU分工决定集群效率
在实际部署中,CPU与GPU的时间分配因用例而异,即便同一用例内部差异也很大。以软件开发为例,模型推理生成代码后,CPU需执行构建、编译和测试等耗时操作,这一环节的关键在于CPU能多快完成分内工作,把控制权交还更昂贵的GPU或加速器,执行流水线的下一步。
正因如此,CPU的快慢直接影响GPU利用率。如果CPU不够快,造价高昂的GPU就会闲置,这是任何用户都不愿看到的结果。这也解释了为何在智能体场景下,CPU可能成为新的性能瓶颈,以及CPU与GPU、DPU如何分工以避免头节点成为瓶颈,成为集群设计的关键命题。
不同场景对基础设施的要求并不相同。软件开发智能体长时间运行、累积大量上下文,需要大容量KV Cache与相应内存、存储支撑;企业客户支持类应用上下文量较小、任务持续时间短,更适合以更大规模、更低延迟运行中小型模型,并针对向量数据库做优化。
从升级动力看,客户支持、供应链管理、个人助理等场景更关注每机架性能,Arm AGI CPU的可扩展性与能效优势在其中尤为突出,有望率先形成基础设施升级需求。而在高并发的企业运营场景中,沙箱开销越低,单位时间内可处理的工单越多,整体效率越高,单个任务成本也随之下降。
结论
访谈中透露出Arm的真实意图并不止于发布一组跑分数据,而是试图为智能体AI时代的CPU性能评估提供一套方法论,在白皮书中主张组件基准与端到端基准并重,强调机架级而非单芯片的衡量尺度,并将“平衡”塑造为区别于x86的核心叙事。
这一动作背后有两层考量。表层是以Signal65的独立报告为Arm AGI CPU背书,在性能、可扩展性与效率之间给出可比的数据支撑;深层则是争夺智能体时代CPU评估标准的话语权——在Arm、x86阵营各自测量、口径不一的当下,谁先给出被广泛接受的评估框架,谁就更可能在基础设施选型中占据主动。
值得注意的是,Arm此次携手富士通、Meta与OpenAI共同发起标准。选择这三家并非偶然:OpenAI与Meta分别代表前沿模型开发者与超大规模智能体部署者,最清楚实际运行中CPU资源的具体环节,富士通则具备系统集成与工程落地经验,三者共同构成从模型到部署的完整视角,使评估标准不失为闭门造车的营销工具。
此举也标志着Arm正从幕后的IP提供商走向台前的算力玩家。
当Arm把讨论从单点指标引向用例与端到端工作流,无论客户最终如何选择,这套以用例为原点、兼顾组件与整体的思路,都为行业提供了可参照的起点。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表