同样四个字,一套求解空间的形状,一套求解因果的链条。
Genie 4与Atlas不是竞品,是两种世界观。
把时间模拟器和空间重建器混为一谈,是这个概念通胀时代最典型的误读。
“世界模型”这个词正在通胀
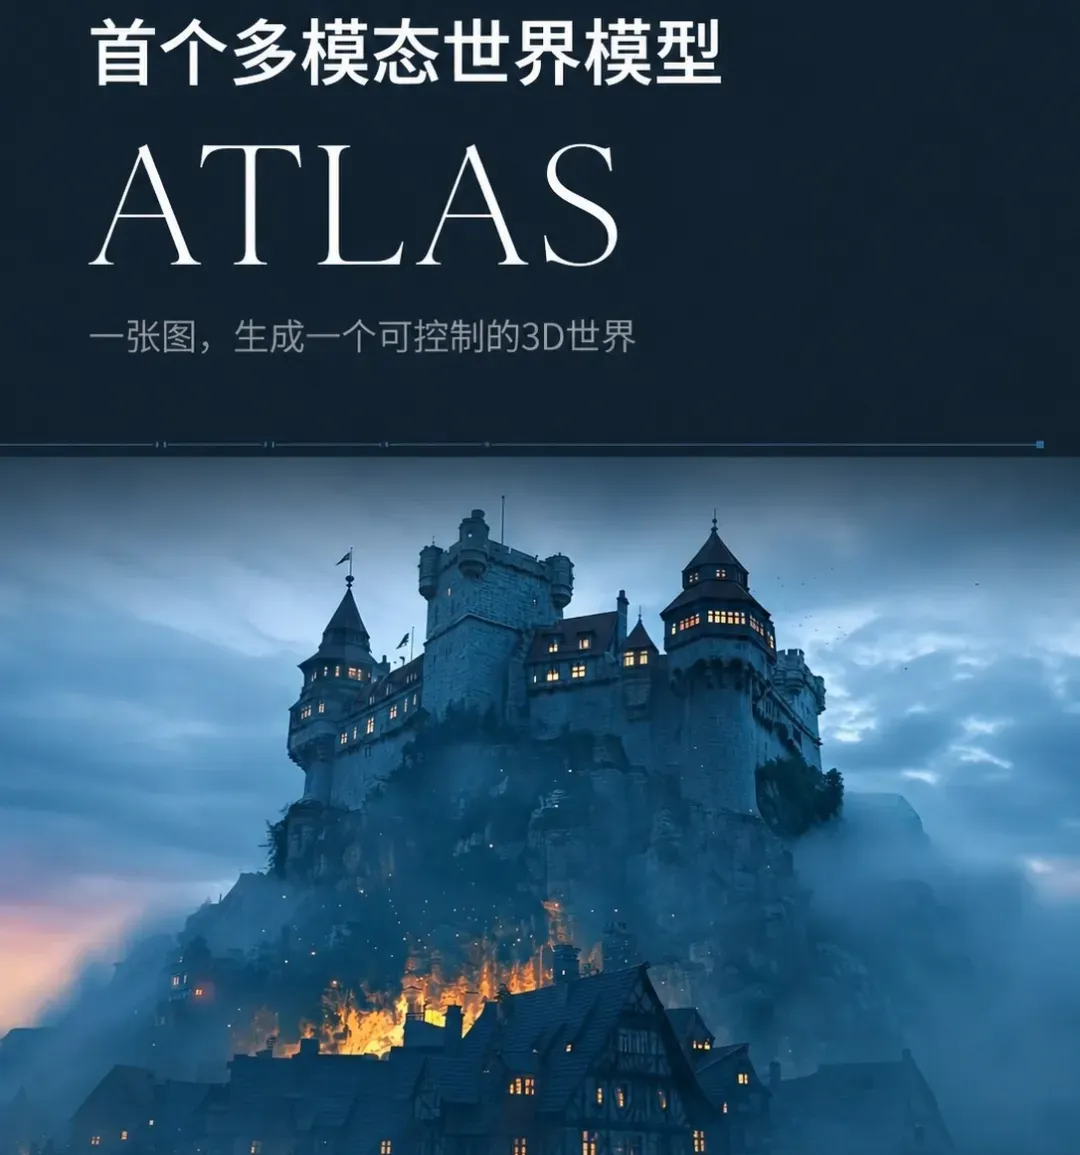
9月1日,World Labs发布Atlas。
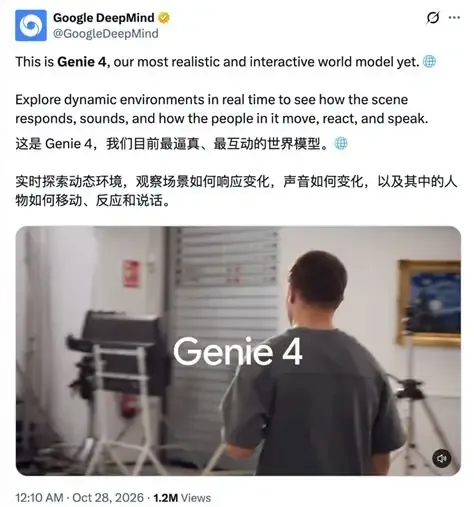
10月27日,DeepMind发布Genie 4。
过去几个月,世界模型四个字几乎出现在每一场发布会上,Runway的GWM Worlds 2也在同一条时间线上登场。
读者的直觉是把它们放进同一个坐标系里比强弱,这是本轮讨论最大的误区。
这个误区有历史原因。
世界模型这个词最早属于强化学习,DeepMind的Dreamer系列是它的源头,本意是让智能体在虚拟环境里试错、预测行动后果。计算机视觉圈后来借用了这个词,沿着NeRF到3D高斯泼溅再到新视角合成的一脉,把静态场景的几何重建也纳入其中。两条学术老线各自产业化,撞上同一个名字,混乱由此而来。
World Labs自己在6月发布的《世界模型的功能分类学》把世界模型拆成渲染器、模拟器、规划器三类及其回路,侧面印证了这种分裂。
本文聚焦前两档的对照。
世界模型存在两条底层路线,空间优先派与时序事件优先派。Atlas与Genie 4,正是两条路线的当代样本。
路线A|Atlas,空间优先,先看懂这个地方长什么样
理解Atlas,要从它的基础原语讲起。
大语言模型的原语是下一个token预测,视频模型的原语是下一帧预测,而Atlas的原语是新视角预测。
给定若干张带相机位姿的观测图像,推断从另一个位置看过去,世界应该呈现什么模样。
这个原语选择的含义很深。
相机位姿是原生输入,不是事后标注。模型从预训练第一天起,就把观测者站在哪里当作与像素同级的信息。 核心约束是跨视角几何自洽。同一个空间,换任何机位,三维结构必须成立。 输入优先是现实观测。照片、实拍视频,能力原点是补全那些未被看见的空间。
3部iPhone,复刻子弹时间
无绿幕、无标定、无相机阵列。三部普通手机架在三脚架上拍摄抛向空中的篮球,即可生成时间冻结、视角任意穿梭的连续镜头。
更极限的演示是仅凭3到25张站在地面手持拍摄的斯坦福庭院照片,重建出空中俯瞰视角。你看到的俯瞰画面全部是生成的,同时又严格遵循重建的几何规律。
李飞飞对此的总结是这是计算机视觉半个多世纪以来,第一次实现像素生成与像素重建的统一。过去生成负责想象、重建负责还原的两条平行轨道,被相机位姿接进了同一个模型。
因此Atlas的本质是一台空间表征引擎。
输出新视角视图、深度图、点云、3D高斯泼溅,全是空间资产。它适合充当Physical AI的感知层底座,机器人先看懂环境长什么样,再谈导航、避障、操作。观测主义的世界模型,从已有的现实观测出发,向外补全世界的形状。
Atlas的时序是相机运动时序,不是物体因果时序。
子弹时间证明它擅长处理观测者的移动,但它不擅长让世界里的角色自主产生连锁反应。你可以任意换机位看这个房间,却很难让房间里的物体彼此碰撞、持续演化出一段带后果的剧情。它也更适配静态和慢变场景,建筑扫描、工厂数字化、机器人静态建图是它的主场,物体密集高速交互的场景会让重建一致性快速松动。这不是缺陷,是路线选择。在它的约束条件里,几何一致性排第一,时序因果排在后面。
路线B|Genie 4,事件优先,先推演会发生什么
Genie 4的约束条件几乎倒过来。它的世界不是一个可以从任意角度端详的空间快照,而是一个随动作与指令持续演化的动态过程。DeepMind研究总监Tejas Kulkarni称之为混合世界模型的起点。
未来我们会越来越多地看到混合世界模型。Gemini负责编写代码与文本,Genie实时消化这些信息,并在不同抽象层级上模拟现实。[据Bloomberg报道]
这套双层循环的结构值得拆解。
Gemini充当导演,拆解目标、逐步执行、逐帧检查画面是否偏离预期。
Genie负责像素级场景仿真渲染与事件音频生成。

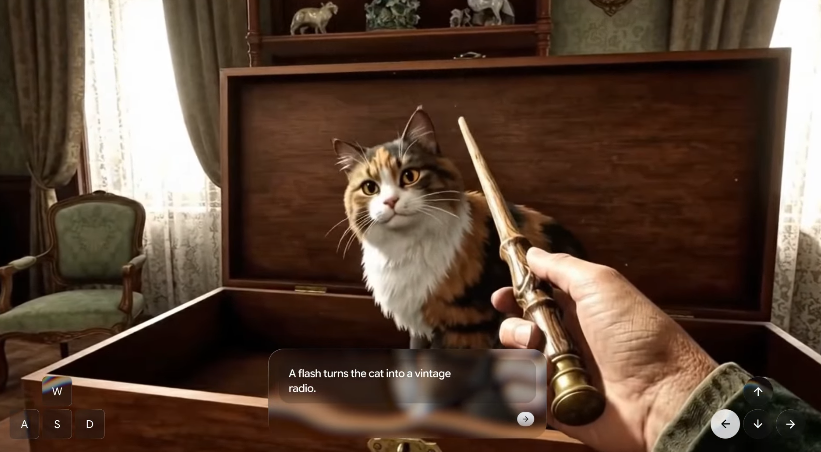
这不是传统游戏引擎的硬编码规则管线。Genie的物理规律是从数据中学来的统计式规律,不是逐条写死的碰撞与重力方程。好处是规则可以被自然语言临时改写,Project Genie时期已有低重力世界的先例。代价是习得式物理缺乏严格保证,误差会在长链条中累积。
它的目标因此不是复刻一个真实场地的三维档案,而是生成一个可被智能体持续试错的动态试验场。Gemini 4 Argon将下跳棋任务拆解为22个精细步骤,指挥Apptronik的Apollo人形机器人在模拟环境中完成整套操作。这展示的是机器人行动的模拟,而非实体机器人已经掌握了下棋。
世界模型给出的每一步反馈,都是符合物理规则的因果响应。
演绎主义的世界模型,从一条初始指令出发,向前推演未来所有可能发生的交互分支。代价是为换取长时程事件的连贯,严格的三维几何一致性被让渡了优先级。镜头大幅跳转时的空间漂移,是这条路线的固有边界,而不是简单的画质缺陷。
两种路线各有一种典型的失败模式,恰好与各自的约束一一对应。
Atlas的幻觉是几何幻觉,透视与三维拓扑崩坏。
Genie 4的幻觉是因果幻觉,动作的连锁反应逻辑在多步之后漂移。看懂幻觉的类型,就看懂了路线的本质。
Genie 4首次加入的原生音频,限定在仿真内部,是事件驱动的伴随音效与角色对白,并非通用语音合成能力。碰撞才发声,角色行动才有对白,声音与时序因果绑定在一起。
而Atlas没有原生交互音频这个设计目标,它的产出就是空间视觉资产。
一个把声音当作因果的音效,一个把声音当作不存在的选项。两种世界观在最小的细节上也自洽。
官方没有公布算力配置,但约束清晰可见。Project Genie阶段披露,每个活跃会话需要独占GPU资源,长时序闭环仿真的算力开销远高于一次性视频生成。这条成本曲线,是它现阶段只能以研究预览形态出现的重要原因之一。
两套约束条件,不是强弱之分
| 维度(纯范式,无计分) | Atlas · World Labs | Genie 4 · DeepMind |
|---|---|---|
延伸研判
Atlas负责把真实世界扫描、转成可信的三维底座,World Labs在7月发布的Real-to-Sim-to-Real管线正是干这个的。 Genie 4在这个稳定空间之上,运行动态事件与智能体试错。 一个提供舞台的结构,一个提供舞台上的故事。现阶段判断,两条路线的终点不是合并,而是接口。 用Atlas的换视角稳定性要求Genie 4,或拿Genie 4的长交互剧情能力衡量Atlas,都会得出另一方落后的错误结论。 两条路线的取舍由各自的约束条件决定。看懂取舍,比比较强弱更接近这个行业当前需要的认知。 纯视频生成模型只预测下一帧画面。既没有严格的空间约束,也没有持续的因果模拟闭环。 World Labs创始团队在与a16z的对谈中有一个精准的比喻,这类模型如同视觉老虎机。输入提示词,随机拉杆,镜头一回环,物体的透视与拓扑就悄然形变。 真正的世界模型壁垒,恰好立在老虎机够不着的那两侧。一侧是几何自洽,一侧是因果自洽。 Atlas的路线离钱更近。实景三维数字化、数字孪生、机器人建图、影视资产生产,B端订单链路成熟,不需要强通用因果能力。 Genie 4的路线门槛更高。仿真训练、人形机器人闭环、交互式虚拟内容,对稳定性与因果保真的要求极高,现阶段判断,它更多停留在科研验证与早期试点阶段,落地周期更长。 以因果仿真为主体、实时调用新视角合成模块做渲染,是一条路。 以静态三维底座为主体、叠加轻量动力学模块、在固定场景内增加有限交互,是很多工业数字孪生正在走的路。 未来会出现大量介于两者之间的中间变种,世界模型的终局不是非此即彼。
Atlas发布仅三周后,World Labs宣布并入AMD,李飞飞出任执行副总裁兼首席科学家。
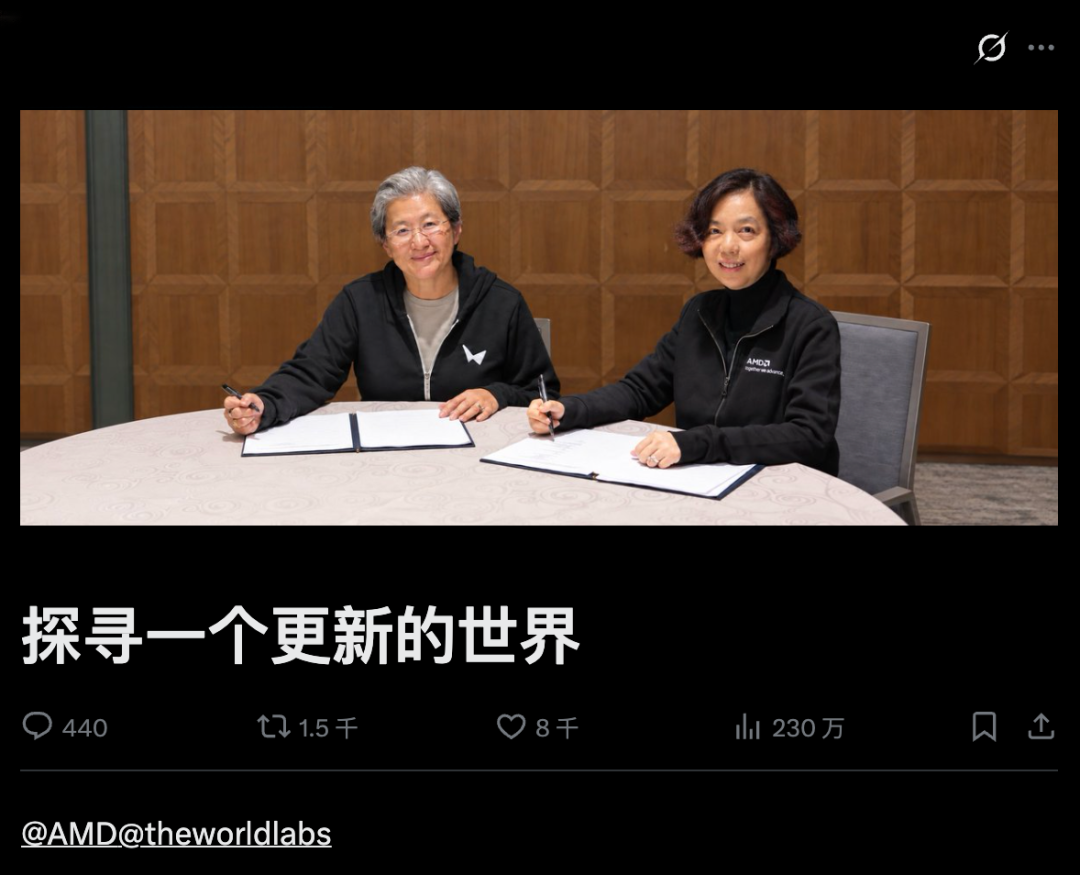
这不只是收购一个模型。
AMD缺的是空间智能与机器人物理AI的软件栈,MI系列GPU与Versal自适应芯片需要空间智能的场景来承载。
空间优先路线由此获得芯片级基础设施的长期押注。两条路线之争,争的不是谁先出圈,而是谁成为下一代AI系统绕不开的底座。
人形机器人赛道正在印证这个上下游判断。
靠近本体感知的一端需要Atlas范式,实时空间重建、定位避障。决策规划的一端需要Genie范式,预演动作后果、仿真试错。已有不少机器人团队同时接触两类能力,而不是押注单一模型。
AGI的世界模型命题,其实分两层
第一层,这个世界是什么形状,Atlas在回答。
第二层,在这个世界里做一件事会发生什么,Genie 4在回答。
李飞飞说过,没有空间智能的AGI是不完整的。Genie 4发布之后,这句话可以补完另一半。没有因果仿真的AGI,同样是不完整的。谷歌这次真正推进的不是画质、不是音频、不是两分钟,而是把世界模型的竞争重心,从生成好看的场景,推进到了可干预、带反馈的因果仿真阶段。这仍是可交互仿真的起点,不是成熟的通用物理仿真器。
行业的考核指标也会跟着分化。用视频模型的画质打分去衡量世界模型,对两条路线都无效。空间路线有自己的标尺,新视角合成的重建精度、几何误差、拓扑一致性。因果仿真路线会有另一套标尺,多步因果保真度、物理规则遵守率、智能体任务成功率。统一的世界模型跑分不存在,因为它们要解决的AGI底层问题本身就不一样。
Atlas教会机器换个位置继续看,Genie 4教会机器走下去,看看会发生什么。一个教会AI观察世界,一个教会AI预演世界。两条路线会在哪个节点交汇,或许才是通往AGI的真正路标。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表