2026年,在AI技术浪潮下坐了几年冷板凳的CPU,突然在数据中心市场迎来了大逆转。
4月财报会上,英特尔CEO陈立武直言,由于智能体的需求爆发,数据中心服务器CPU与GPU的配比即将从8:1变成4:1甚至1:1,CPU随后受到猛烈关注。
9月,Meta发布Muse,这类能够持续执行任务的Agent需要独立的云端执行环境,包括虚拟机、浏览器、文件系统等,而这些基础设施背后都需要大量CPU资源。
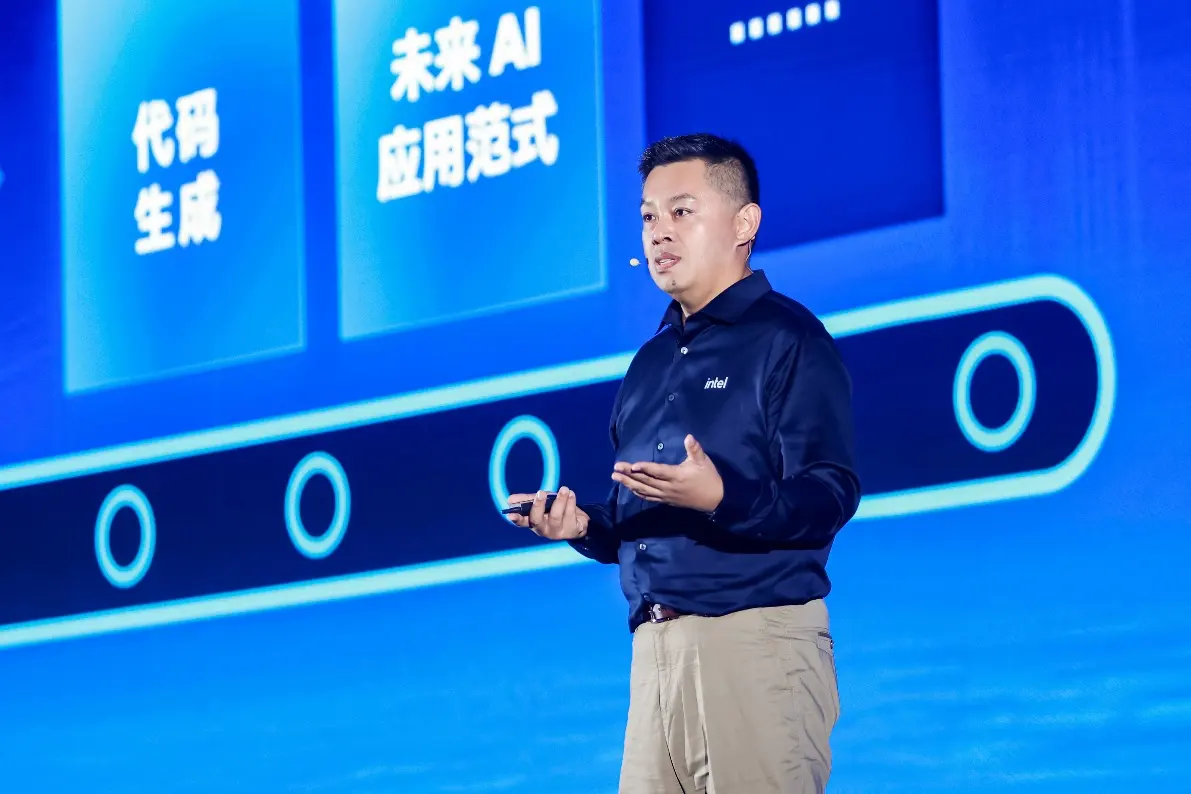
9月22日,在2026英特尔技术创新与产业生态大会上,英特尔数据中心集团副总裁、中国区总经理陈葆立引用了美国银行的数据:2026年2月,市场预测到2030年CPU市场规模将达到590亿美元,而到了8月,这一数字被上调到了2100亿美元,暴涨了3.6倍。
英特尔回应“只能满足大约50%的客户需求”这一说法
市场对CPU的需求强烈可见一斑,但全球范围内都高度竞争的CPU市场,终究还是供需关系决定价格。
今年以来,单是媒体报道就多次提到CPU涨价的消息。2026年9月,英特尔CEO陈立武再次公开表示,CPU需求非常高,英特尔目前只能满足大约50%的客户需求,这一数字将CPU的需求热度再次提升。
陈葆立在随后的采访中进行了一番解释。他认为,不应该把这一数字简单理解为真实市场需求是当前供应能力的两倍。因为,在供货紧张时,客户往往会为了避免被砍单而主动放大订单需求量,或者重复提交订单。
在他看来,订单层面的需求会存在一定程度的放大。这一说法或许是为了缓解用户的采购后焦虑,不过从实际情况看,真实需求仍然明显高于当前供应能力,只是具体缺口究竟有多大,很难通过50%这一数字来粗暴的下结论。
CPU缺货涨价的趋势短期内很难改观,毕竟GPU、HBM、DRAM到SSD都在缺货。不过,陈葆立认为,Intel 18A制程量产已经比较顺利,后续会用新产能来缓解供应压力。
当然,CPU缺货值得关注,这次大会也讲清了缺货背后的原因:AI智能体一旦开始真正干活,背后需要处理的编排、调度、隔离、数据搬运,绝大部分都得靠CPU来扛。
Agent智能体引爆CPU市场需求
陈葆立在演讲中提到,预计到2026年底,超过80%的企业应用会至少嵌入一个AI智能体。IDC预测,到2031年,中国企业场景里的活跃智能体数量能达到3.5亿个。中国大模型每天的Token调用量,已经涨到了2024年初的5000倍。
以前AI就是个对话框,问一句答一句。现在通过Context Engineering,AI能结合长上下文和多轮对话理解你的背景。再往上,Harness相当于给AI装上能干活的手,Loop Engineering让AI像个爱较真的学生,写完答案还要反复验证改进。
这背后是Agent智能体时代下,AI软件栈本身的变化。陈葆立强调,这几层机制当中,有很多工作都特别适合CPU来执行,这就是过去一年CPU需求暴涨的直接原因。
有数据预测,数据中心里AI负载的占比,会从2025年的40%涨到2030年的80%,这意味着整个数据中心架构都要因为AI重新洗牌。直白点说,CPU作为其中非常重要的一部分,市场需求会非常大。
英特尔把未来AI数据中心的资源更细致地拆成了三类集群。其中,CPU集群负责智能体执行和工作编排,GPU集群负责生产Token,再加一个高性能存储集群负责存文档、对话记录这些新产生的数据。
在英伟达的叙事结构中,以GPU为核心的数据中心被称作是Token工厂。而现在,数据中心的三类集群都离不开CPU,于是,英特尔提出了AI工厂的概念。其重点不再是强调产生多少Token,而是整个系统怎么用更低的资源消耗完成更多任务。
英特尔至强如何以更低的资源消耗完成更多任务
今年6月发布的至强6+采用Intel 18A制程,288个内核,单颗能部署近1000个智能体。但客户的反馈是,光数量多不够,还得跑得快,所以英特尔调整了下衡量维度,不仅要看单颗CPU能带多少个智能体,同时还要看每个智能体本身的性能。
具体测试上,在SWE-bench基准里,至强6+的单智能体平均性能领先竞品15%。在Agent场景下,客户要求10分钟内启动10万个沙箱,单个沙箱启动速度要在200毫秒以内。在满足要求的前提下,至强6+能支持350个沙箱并发,约为竞品的1.46倍。
英特尔数据中心集团软件工程经理胡勇解释了大模型为什么需要沙箱这个隔离环境,而沙箱为什么这么依赖CPU的设计。沙箱本质是轻量化虚拟机,运行目标是启动要够快、占用内存要够少,而至强6+恰好在几个地方对上了这个需求。
一方面是它200多个核心即使同时重载也不降频,交付性能几乎线性的,稳定的性能输出,意味着它能以更高的并发性能创建和销毁虚拟机。二是它支持超配,能分时复用资源,从而让一个核心能同时跑4到5个Agent。
第三,从第四代至强可扩展处理器开始内置的IAA、QAT、DSA等加速器,在处理数据的压缩解压、加解密、搬运时,几乎可以不占用CPU或GPU本身的算力,这些加速器能够帮助数据的搬运。
即便GPU侧负载也同样离不开CPU。陈葆立提到,数据在喂给大模型之前需要预处理,很多不同格式的资料要先提取文字,这部分工作适合CPU而不是GPU来做。借助至强内置的AMX加速器,实测中,向量化和重排序性能分别达到对比基准的2倍和4倍。
英特尔软硬结合,缓解智能体KV Cache管理的痛点
KV Cache是AI基础设施领域最火的技术概念之一。KV Cache可以理解为大模型推理时的一份“计算缓存”。但现在随着问题越来越复杂,上下文越来越长,大量Agent协同工作时,反而把更多时间花在了存储和管理KV Cache上,而不是思考。
具体到数字,一个35B模型如果给到100万Token上下文,产生的KV Cache能到300GB,早就超过现在GPU上的HBM容量。因此,要将这些KV Cache从HBM转移DRAM内存或者到SSD。
为此,英特尔推出了KV Cache智能加速套件,包括KV Infinity、KV Shrink、KV Cascade以及KV Fuse四个方案,覆盖KV Cache扩展、压缩、聚焦、复用的整个生命周期,这套KV Shrink方案已经在GitHub开源。

其中,KV Shrink通过QAT可对KV Cache进行压缩,可以将原来300G的KV Cache压缩到200GB。通过DSA加速数据搬运,能达到9.66倍加速效果。在减少KV Cache容量占用的同时降低数据迁移开销。

在与类似LM Cache相比时,由于KV Shrink能更好的利用硬件加速器,软硬结合,在同等命中率的前提下,KV Shrink在各个并发水平下的首Token的延迟都更低,大概相差了20-30%的水平。

CPU市场规模正在急剧扩张,谁会是市场的最大赢家呢?
面对未来2100亿美元的CPU市场规模,x86会是最大赢家吗?陈葆立在现场给出的判断是,到2030年全球在网运行的服务器里,预计仍有超过80%基于x86,这个数字是基于当前全球约7000万台在网服务器存量推算出来的。
x86的优势不仅在于产品技术成熟,更在于软件生态的繁荣。陈葆立举了个例子,如果让Agent去做抠图这类它本身不具备的能力,它会自己上网找开源代码来跑,而这些沉淀了许久的开源代码,大概率是基于X86架构写的。
陈葆立也多次提到,严格来说,今天还没有真正意义上所谓为智能体而生的服务器CPU。因为CPU从架构定义到量产往往需要数年时间,目前这一代至强6在立项时,Agentic AI还没有形成今天这样的规模。
不过,英特尔至强这些产品特性在面对智能体负载时,确实展示出了一定的优势。更重要的是,智能体负载已经开始影响下一代CPU设计,包括增加CPU前端和每个核心可用的资源、优化调度和流水线效率,同时提升内存容量和带宽等。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表