进入2026年,AI智能体的Token用量进入快速增长期。高盛研究部负责美国半导体与IT服务的资深分析师Jim Schneider表示,随着消费端与企业端AI智能体落地普及,2026年至2030年间,AI智能体的Token消耗量预计增长24倍,在2030年达到每月120 千万亿(quadrillion)Token。
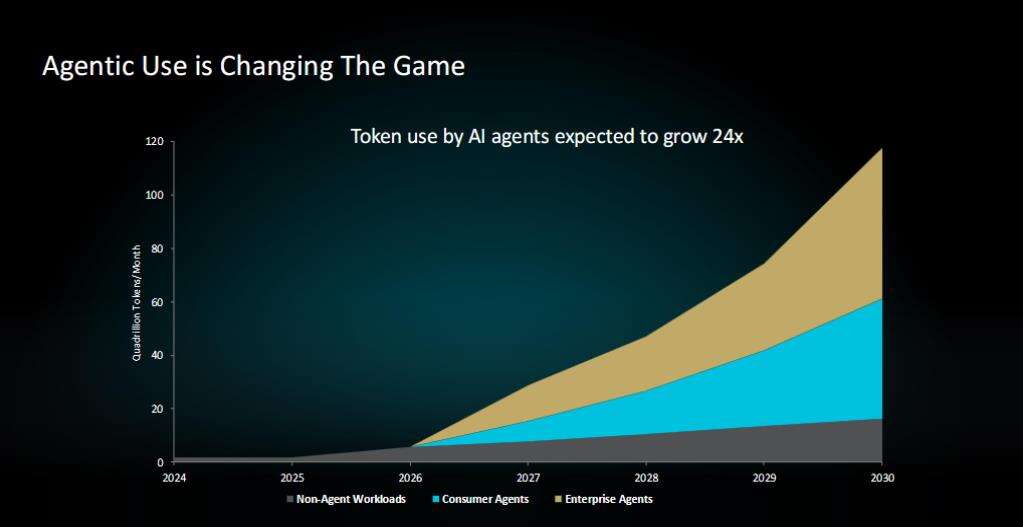
四年间,AI智能体的Token使用量预计增长24倍
这将数据中心运营者推到了一个并不舒适的位置。他们既要继续支撑手上已有的工作负载,又必须为不断涌来的智能体工作负载腾出空间,而且不只是CPU节点,GPU节点同样吃紧:有人被功耗预算卡住,有人被机架空间卡住,还有人两头受制。
AMD计算与企业AI产品集团企业副总裁Madhu Rangarajan
11月5日下午,AMD计算与企业AI产品集团企业副总裁Madhu Rangarajan在AMD In Depth 2026的分会上做出演讲,指出客户需要在既有约束条件下,用更少的资源做更多的事。
智能体工作负载成倍增长,需要领先算力;机架需求出现分化,需要开放的机架级方案;部署复杂度上升,需要可扩展的软件框架。在既不能推倒重来、又不能停止扩张的前提下,算力结构本身必须先被重新排布。当天发布的“面向Agentic时代的新一代AMD解决方案”,给出了理想的对策。
算力重心迁移:从聊天机器人到“执行实际工作”的智能体
在聊天机器人时代,链路相当直接:用户发起查询,聊天机器人给出回答,用户再基于回答去采取行动。智能体AI加入了一个关键变化:发起查询的不只是人,还有智能体;推理依然发生、依然是核心,但智能体本身会基于生成的token去执行工具调用,再验证这些调用是否真的达成了用户的目标,如果没有达成,它会循环回去重走一遍,可能反复多次,最后才返回结果。
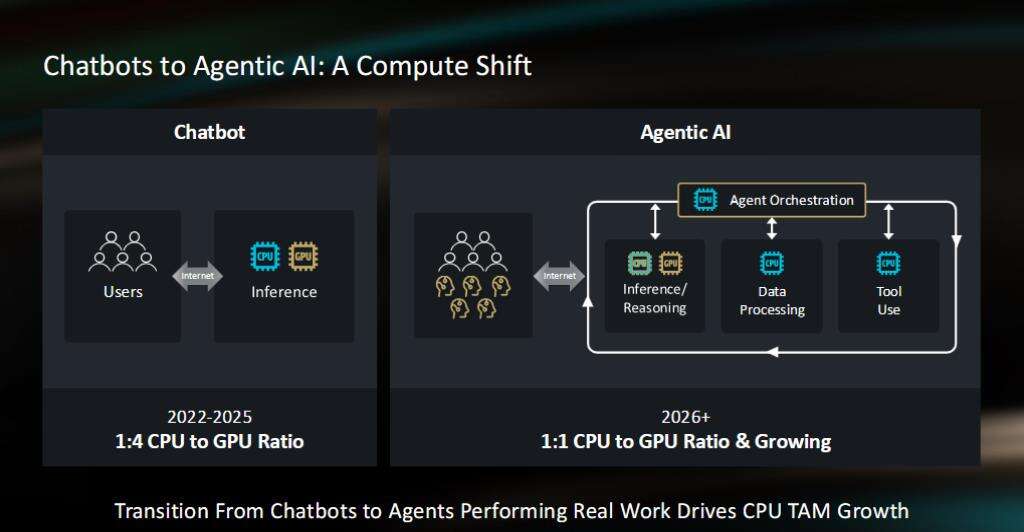
CPU与GPU的配比已经变成1:1并且继续向CPU侧倾斜
这一变化最直观的体现就是CPU与GPU的比例被翻转:2022到2025年,配比是1颗CPU对4颗GPU;如今已经变成1:1,并且还会继续向CPU一侧倾斜。
因为从聊天机器人到“执行实际实工作的智能体”,这一转变本身就带动了CPU整体市场的增长。
八阶段流水线,与增长最快的临时工具层
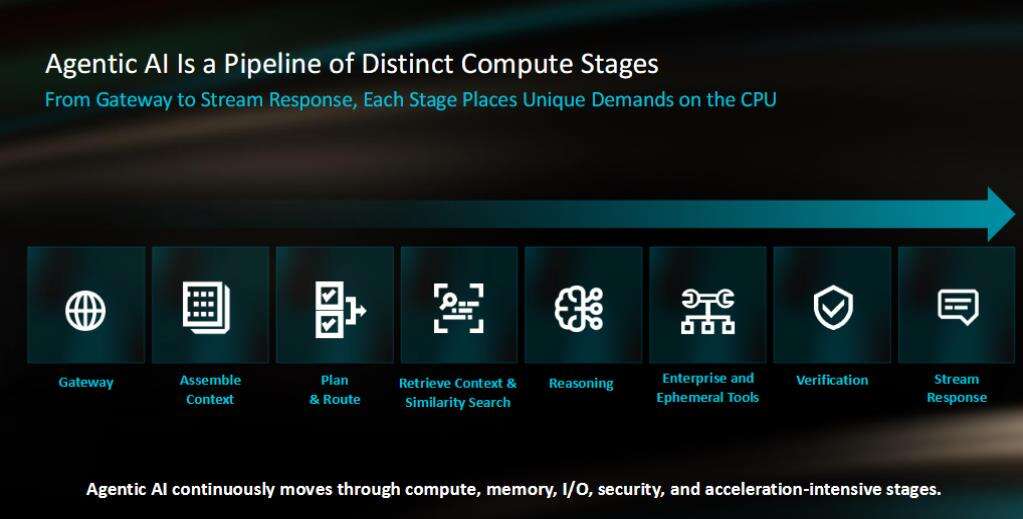
Agentic AI持续在计算、内存、输入/输出、安全以及密集型阶段之间流转
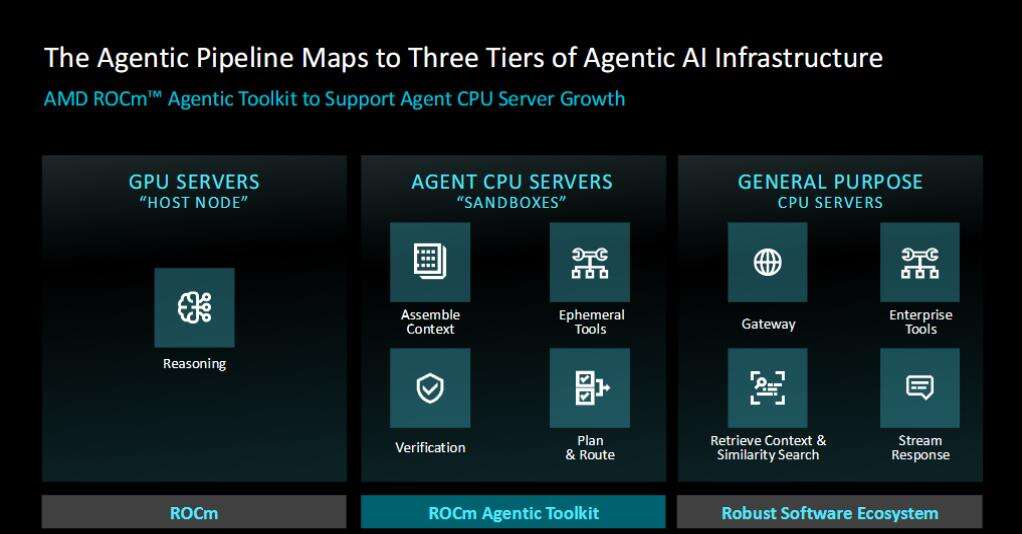
这条流水线由八个阶段组成:网关、组装上下文、规划与路由、检索上下文与相似度搜索、推理、企业与临时工具、验证、流式响应。智能体AI会持续在计算密集、内存密集、I/O密集、安全密集与加速密集的各阶段之间流转。而这些阶段不是抽象的框图:网关要完成认证、限流与安全检查,并存储或恢复会话;组装上下文要把历史记录、默认提示词、用户输入与策略追加的提示词拼装成完整窗口;规划与路由要决定“我要做什么、要发起哪些工具调用”,这些基本发生在CPU上;检索阶段要为新信息补上训练数据里没有的内容;工具执行则可能从智能体现写的一小段代码,延伸到10到30次彼此级联的调用,例如向EDA集群提交一次仿真作业。
据介绍,其中真正把CPU需求推高的是“临时工具”这一层。它对应的是一批短生命周期、沙箱化、在大规模并发下起停的任务,负载类型覆盖编程、安全、RAG数据摄入、上下文压缩与媒体处理。这类负载的关键变化在于,过去它们大多运行在客户端,用于改文档、调配置,如今被搬到服务器端,且是成千上万个同时运行在同一节点上,等于把客户端类负载放进了服务器环境。也正因负载形态被改变,其性能评测需要重建。
Venice四款组合,跨阶段领先最高3.5倍
面对被拆成八段的负载,单一SKU是无法兼顾的。第6代AMD EPYC推出了四款组合:
9006 SP7(Venice)主打性能,核心数与性能都是领先项;9006 SP8(Venice)面向企业级,优化“每系统每美元性能”,很多EDA类工具受益于此;9006X SP7(Venice-X)面向HPC;9006 LP(Verano)面向AI主机节点加LPDDR,目标是让CPU在GPU节点旁绝不成为瓶颈,因此需要高主频与足够的CPU-GPU带宽把GPU喂饱。
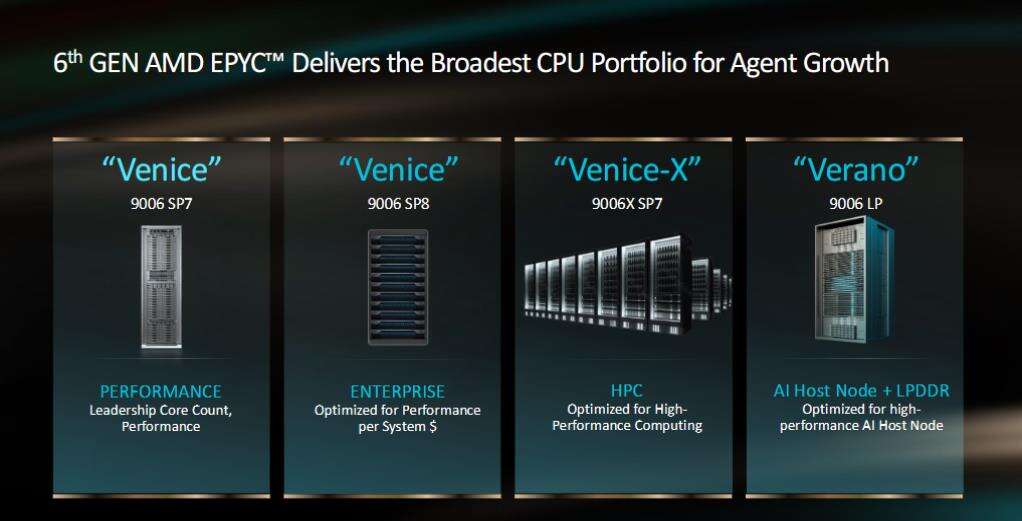
第6代AMD EPYC Venice的四款组合
在跨越这些阶段的性能表现上,同核数的AMD EPYC“Venice”相对竞品在跨所有这八个阶段时,大多数情况下领先2.4到2.5倍,分词与编排这类新兴负载方面达到3.5倍,吞吐量方面,AMD是竞品的2.8倍、单核性能和内存带宽都是1.3倍,分别对应更高的智能体密度、更低的智能体延迟与更强的并发供给能力。
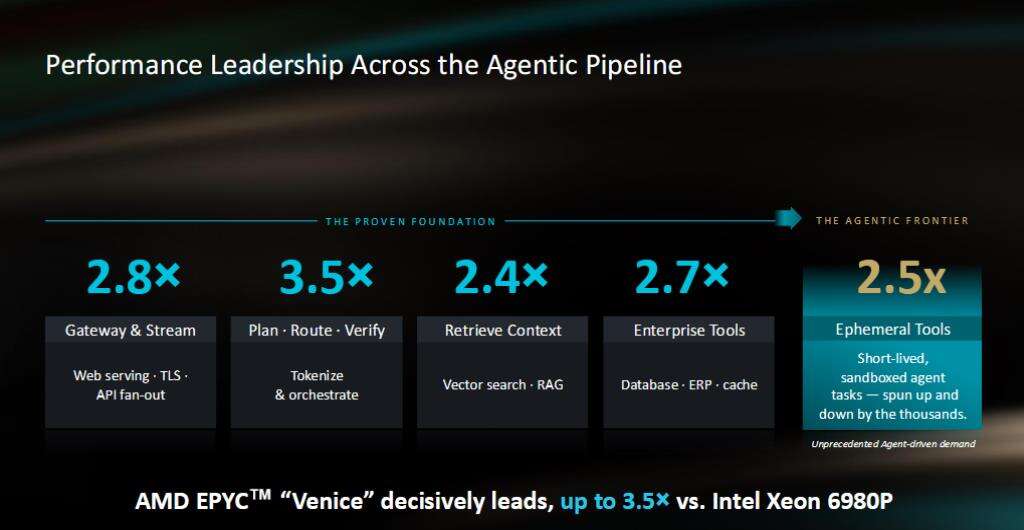
在跨所有这八个阶段时,Venice在大多数情况下领先竞品2.4到2.5倍
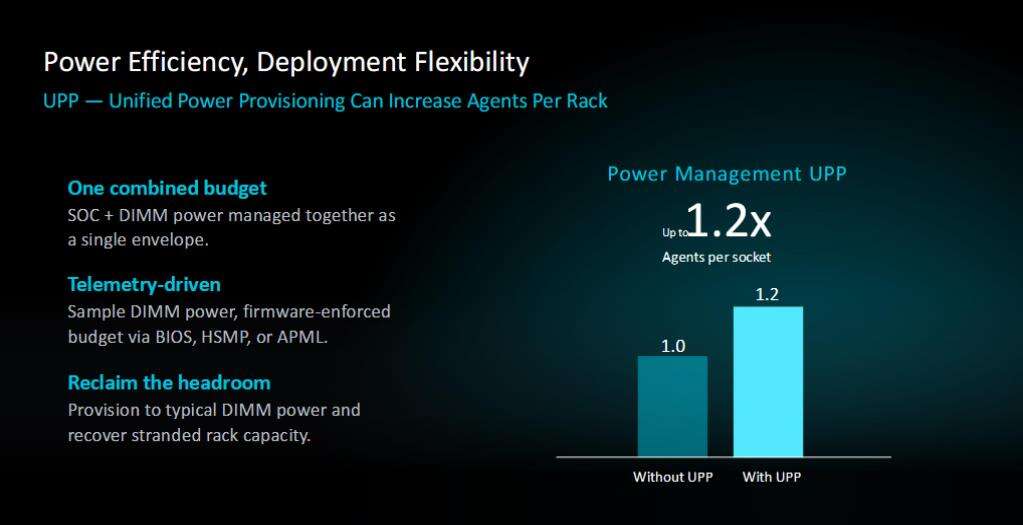
单插槽智能体数量最多提升1.2倍
平台层面的UPP(统一功耗供给)把SOC与DIMM功耗作为单一功耗包统一管理,按典型DIMM功耗规划供给、回收闲置余量,使单插槽智能体数量最多提升1.2倍。
机架给出选择,软件把机架“整合”成一个平台
机架层面,AMD提供的是组合而非唯一答案:Helion Liquid液冷最高36,864核,Helion Air风冷最高16,384核,Helion Air Inference风冷CPU+GPU组合最高12,288核并配16×MI350P,Helios液冷CPU+GPU采用5.3GHz 72×MI455X。
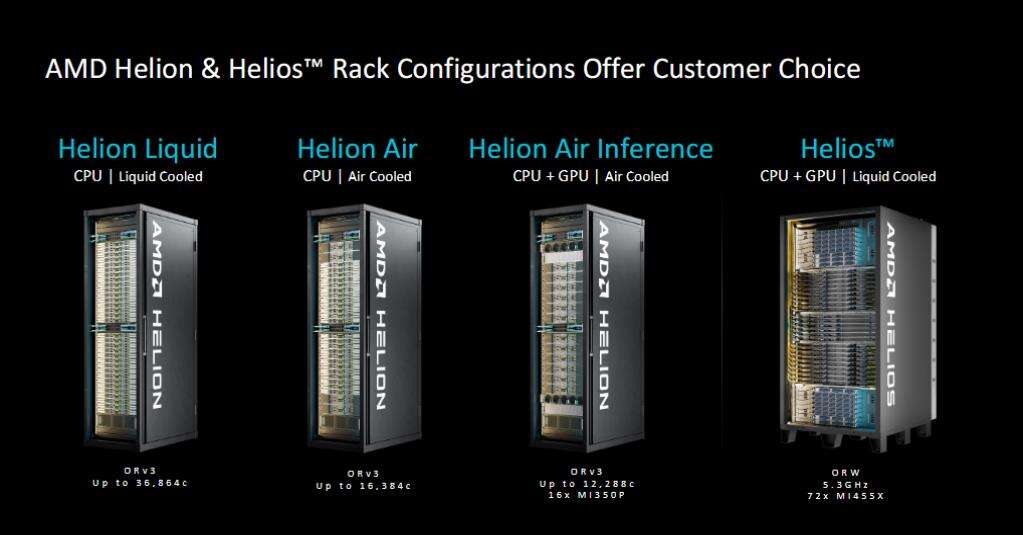
AMD Helion和Helios的机架配置为客户提供多种选择
在这个“交钥匙”的方案中,Helion既提供CPU核心跑其他工作负载,也提供MI350P这类面向企业级应用的较小GPU,用来直接运行智能体负载;Helios交付的是前沿级别能力,可以与上述任何一种机架互补。这种多样性的前提是开放:单一CPU规格、规定机架设计与受限生态,对应的是“灵活机架配置+广泛开放生态”的另一条路。
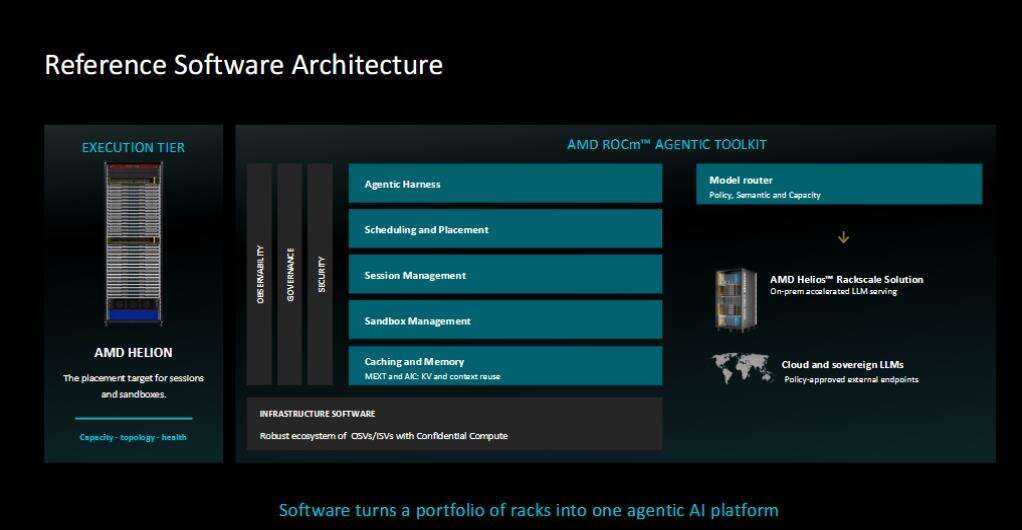
AMD ROCm智能体工具包把机架组合成一个平台
真正把这些机架组合成一个平台的,是AMD ROCm智能体工具包。它把流水线的各阶段对应到三层基础设施上:GPU服务器作为“主机节点”承担推理,由ROCm支撑;智能体CPU服务器作为“沙箱”承担组装上下文、临时工具、验证与规划路由,由ROCm智能体工具包支撑;通用CPU服务器承担网关与企业级工具,依靠成熟的软件生态。工具包内部包含智能体执行框架、调度与放置、会话管理、沙箱管理、缓存与内存(MEXT与AIC,用于KV与上下文复用)以及模型路由器。控制平面负责会话的恢复、检查点与过期,执行侧则区分持久化工作区的会话沙箱与临时、可复制的工具沙箱,后端可选axis、Docker、gVisor、Kata、Firecracker、MXC。模型路由器按策略、语义与容量三类维度决策,落地到AMD Helion、AMD Helios或经策略批准的主权与云端点,并保留路由证据用于审计——同时明确一条底线:不跨策略边界做静默回退。
算力、机架与软件三线并举:以较少投资办更多事情
总体而言,AMD对算力重构给出的回答,落在三条并行的主线上。一是CPU层面的产品组合,以最高核心数、最高主频与第6代机架规模化的产品覆盖不同阶段的需求;二是机架层面的部署选择,Helios与Helion基于开放标准构建,依托成熟生态,让客户按自身数据中心条件决定液冷或风冷、CPU或CPU加GPU的形态;三是软件层面的开放生态,ROCm智能体工具包承接智能体CPU服务器,在x86兼容的前提下把不同机架统一为一个可管理的平台。
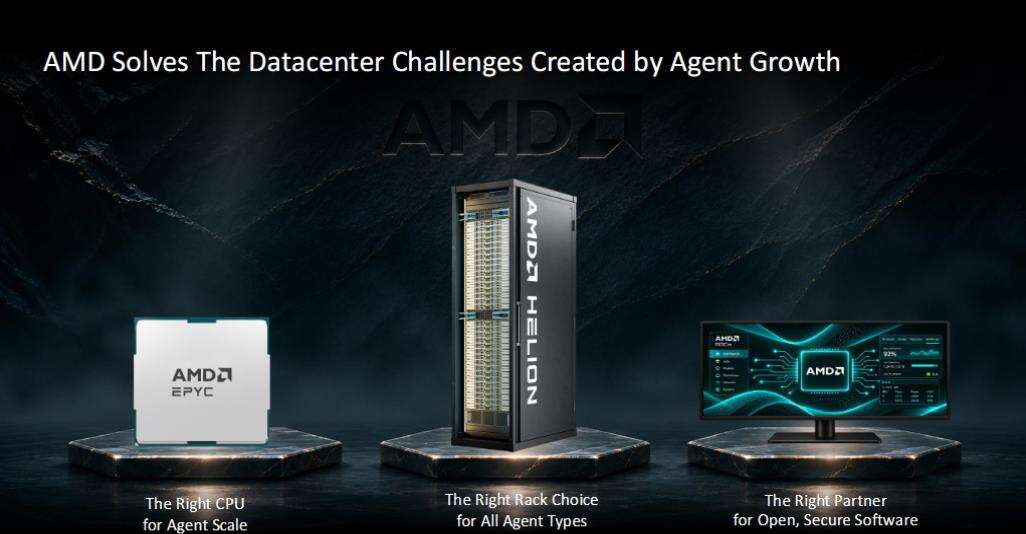
三条主线效应叠加,有效化解Agent增长给数据中心带来的挑战
这三条主线效应叠加:CPU决定单点能力上限,机架决定部署边界,软件决定这些能力能否被真正组织起来使用。体现在执行动作上,就是扩展CPU、扩展机架、扩展软件;在经营逻辑上,便是在既有约束下,帮助客户用更少的资源做更多的事。
一句话,新一代AMD解决方案,有效化解了Agentic数量增长带来的数据中心挑战。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表