软通华方推理服务器部署Qwen3.8-27B TP2模型运行电子病历生成与质控,在启用KVConnector分层卸载(HBM ⇄ DRAM ⇄ Solidigm QLC SSD)后的真实KV写入、读取及推理复用表现,显著优于不使用外部KV Cache的HBM-only基线。在仅增加一块Solidigm D5-P5316 30.72TB QLC SSD作为KV Cache卸载介质的情况下,端到端延迟可降低85%,有效吞吐提升4.6倍。
测试背景
在住院电子病历AI生成与质控业务当中,其上下文长度显著超过了门诊病历。病房场景的病历所需输入的上下文包括完整住院病历、质控规则库注入的RAG上下文,导致KV Cache规模过大。出于数据安全的考虑,医院需本地部署推理服务器,单台服务器内配置两块AI加速卡,共128GB HBM。受限于服务器内HBM容量,在长病历上下文及高并发场景下,经常发生KV Cache溢出,导致业务端到端延迟过大。
将KV Cache卸载至SSD是解决KV Cache频繁溢出的技术手段,本次测试将验证卸载后的性能收益(时延、有效吞吐量)、QLC SSD稳态直写情况、实际写入量及写入放大情况,并估算卸载盘的寿命。测试场景覆盖病历的实时质控与批量质控,其中批量质控体现的是医院闲时(晚11点至次日凌晨6点)定时集中处理的场景。
备注
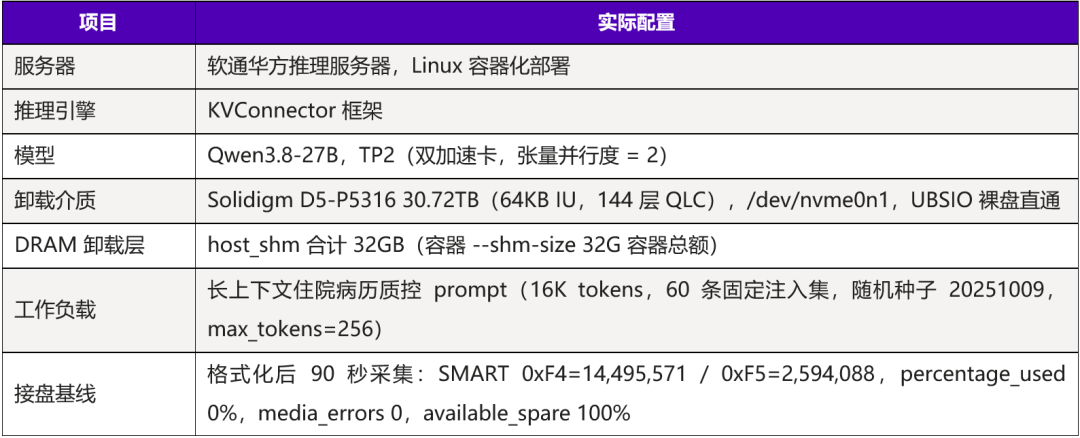
DRAM卸载层受容器 --shm-size 32G 硬约束(合计32GB,无法扩容,如实标注)。持久层走UBSIO(User-space Block Storage I/O)用户态NVMe直通,应用程序绕过内核文件系统/块层直接访问NVMe SSD,缩短I/O路径、降低延迟与抖动。
Qwen3.8-27B是270亿参数大模型,单块加速卡的64GB HBM装不下全部权重且无法再留出KV空间,故采用张量并行(Tensor Parallelism)进行协同。
环境纯净度:测试启动前执行nvme format全盘格式化,清除首轮遗留的全部KV池数据与索引,确保卸载臂自真正的冷池起步。负载集、压测器、双臂配置与判据与首轮完全一致,两轮差异仅反映环境纯净度影响。
SLA(Service Level Agreement)门限:服务等级协议中承诺的性能红线;本场景双门限为E2E(端到端)P99≤15s且TTFT≤5s;闲时批量档另设P99≤60s宽判据。
端到端延迟测试
在60条高并发注入负载的基线组测试中,首遍测试的E2E(端到端)P99尾延迟达到307.0秒,为SLA门限(15秒)的20.5倍,且复访并无改善(309.7秒);首遍测试的TTFT(首Token时间)为155.3秒,复访为159.3秒。基线测试的首遍、复访测试基本一致或略有下降,说明两次基线测试均无缓存收益。
开启卸载后,命中段E2E P99降至50.4秒,相对基线改善6.1倍、尾延迟下降83.6%;热稳态进一步收敛至47.3秒,相对基线下降84.6%。有效吞吐由基线测试的每秒0.099个请求提升至0.454个,改善达4.6倍。
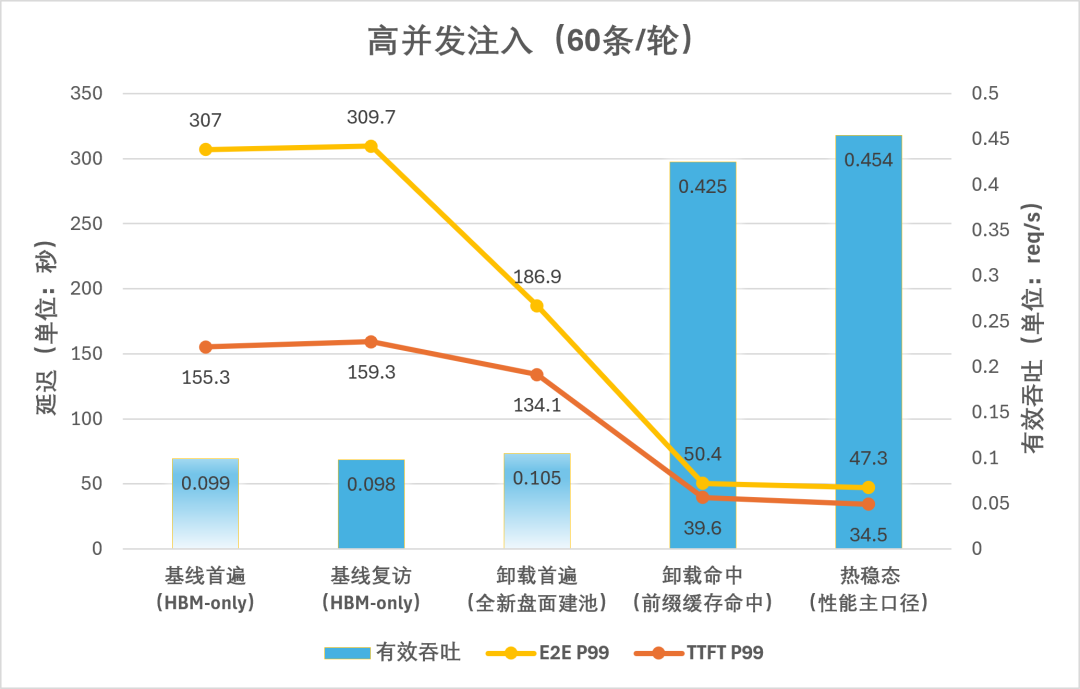
值得一提的是,开启卸载的首遍测试即出现了性能改善,这是HBM容量节省的结果。卸载方案将KV容量外置(DRAM 32GB + Solidigm QLC 30.72TB),HBM KV池主动收缩至8.48GiB/卡。换言之,即使缓存未命中,卸载方案也会带来性能收益。后继测试的收益来源为前缀缓存命中,命中读回耗时为百毫秒级,替代了Prefill重算数十秒级的耗时。
满负载的测试E2E P99结果超过了SLA门限(15秒),以该结果为参照,通过控制目标吞吐量(范围0.32req/s至0.5req/s)以获得不同的延迟,进一步判断推理服务器更贴近实用需求的负载能力。
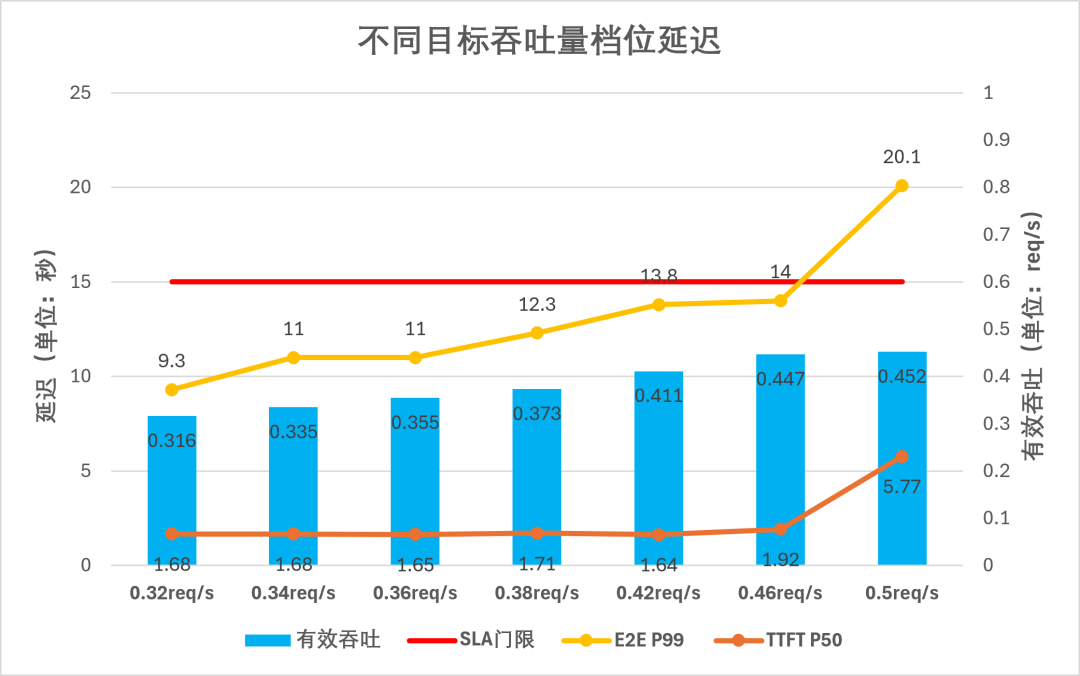
每一个测试点均为每轮60请求,全部 60/60 成功。0.42req/s及以下各档 E2E P99处于9.3~13.8秒区间,SLA达标。0.46req/s档位为贴线点,E2E P99已达14秒,但实测的有效吞吐不足0.45req/s。而基线配置在高并发溢出档的吞吐量上限仅0.1req/s、E2E P99超标20倍,卸载方案将本不可交付的SLA门限扩展出了达标运行区间,且有效吞吐量达4倍以上。
显存水位0.65配置下执行服务重启,设定0.3和0.15两档测试,E2E P99/TTFT P50分别为9.9秒/1.9秒和6.2秒/1.2秒,SSD层索引存活得到验证,缓存命中能力未因服务重启而丢失。
稳态浸泡
第二组测试为120分钟持续压测,搭配低速率背景负载(655条请求记录),累计主机写入1193.3GiB,占30.72TB标称容量约4.2%。测试过程中,稳态直写速率169.7MiB/s(178.0MB/s),全程无衰减,与首轮171.8MB/s基本相当。全程PCIe AER错误与I/O超时计数为零。
Solidigm D5-P5316在长时运行下,655条请求全部成功、零失败零错误,延迟与吞吐均无衰减。按浸泡窗口四等分统计端到端P99延迟分别为:56.1、64.0、66.0、64.8秒,首段略低属于预热尾段,中后段基本持平且末段的延迟测试值出现回落,未出现性能持续劣化的趋势。
实际写入量统计
NAND写入量和主机写入量的计数器值来自nvme intel smart-log厂商扩展0xCA,分别为NAND Bytes Written(0xF4)和Host Bytes Written(0xF5),RAW单位32MiB/count。0xF4定义包含user+system areas写入(即含GC/磨损均衡放大),可直接用于WAF计算。数据读取均上电/测试后至少等待90秒进行,确保取到的是最新值。
WAF = Δ(NAND Bytes Written, 0xF4) ÷ Δ(Host Bytes Written, 0xF5)
本次测试各阶段及全程写入量参见下表:
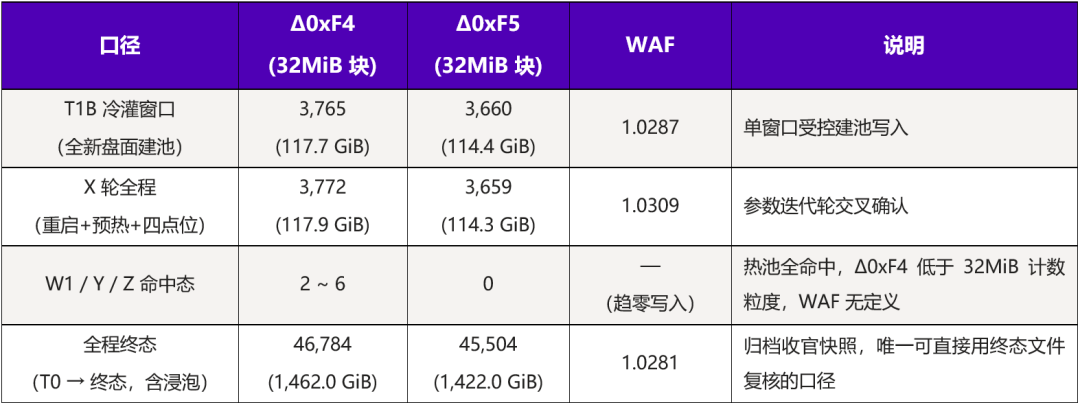
全程主机写入量约1422.0GiB,WAF为1.0281,说明Solidigm D5-P5316在KV Cache卸载大块顺序写形态下的写放大水平稳定,64KB粗粒度Indirection Unit并未对本业务写入产生放大惩罚。
Solidigm D5-P5316 30.72TB容量点的标称耐久度为64KB随机写口径0.41DWPD(5年)/22.93PBW;64KB顺序写口径1.86DWPD(5年)/104.55PBW。以22.93PBW作为最保守的计算口径,5年质保期的反推写入预算约为12200GB/日,相当于本次测试总写入量的8倍,或2小时压力测试的10倍。如果假设业务侧规划写入强度为日均2800GB,外推该盘使用寿命超过20年。
测试结论
使用Solidigm D5-P5316作为卸载目标,扩大了可复用KV后备空间(DRAM 32GB + SSD 30.72TB),命中时减少长前缀重算(百毫秒级读回替代数十秒级prefill),有效吞吐量可达无卸载基线的4倍以上,且端到端尾延迟真正达到可用水平。整个测试过程中,写入放大轻微、两小时浸泡压测无性能衰减、重启服务后数据可再生,用户对QLC SSD三重顾虑(写放大/寿命/抖动)在实测中均不成立,且64KB粗IU在KV Cache的大块顺序写形态下未产生放大惩罚,使用寿命即使按最保守的64KB Random口径外推也远超质保周期,顺序口径余量更大。
卸载方案需要CPU中转内存与H2D/D2H拷贝,首次冷建池产生186.9秒延迟与约114.4GiB(实测值)写入,未命中时仍需prefill重算,命中时的读取延迟显著低于重算开销。本案例选择裸盘直通方案,部署简单,边缘推理一体机只要有预留NVMe U.2盘位即可部署。裸盘直通方案的优势是访问路径短,性能抖动小,但大容量盘的单点故障影响面更大,生产部署需结合业务可用性要求评估。本次浸泡压测累计写入仅占盘容量4.2%,未覆盖高水位(>70%)下的稳态行为。部署建议以gpu-util 0.65 + rate ≤0.3为本平台实测达标工作点;生产运行水位控制在≤0.38 req/s(红线约82%),结合实际命中率再行上调。
大容量QLC SSD用作KV Cache卸载的建议场景
长上下文文档(住院病历质控、合同审阅、代码库问答):单会话KV Cache可达GB级,同一长文档多轮提问命中复用率高,本测试所验证场景即属此类;
多租户客服/企业知识库:“池满排队”痛点最集中,30.72TB单盘容量可承载远多于小容量盘的并发会话池;
Agent/工作流类推理:共享system prompt与检索上下文,换出后直接读回;
单机/边缘推理一体机:整机预留NVMe U.2盘位即可(需PCIe Gen4 x4 与直通前置条件)。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表