DEEP DIVE · 深度研析
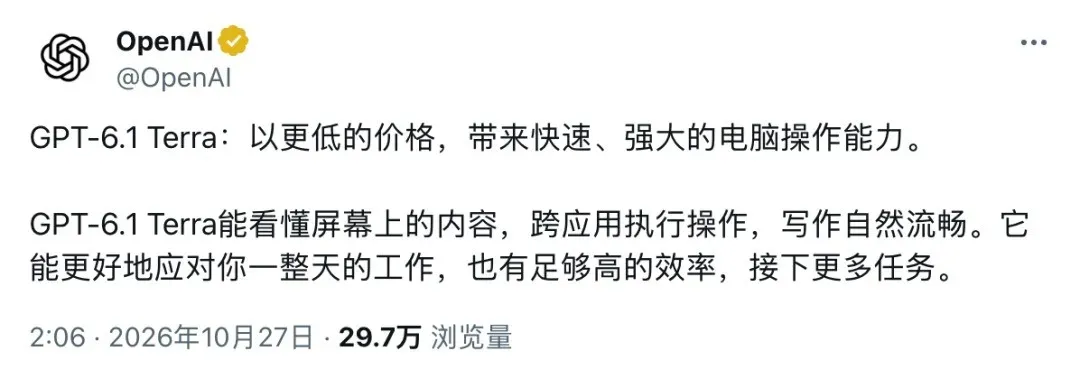
美国时间10月26日(北京时间10月27日凌晨),OpenAI发布GPT-6.1 Terra。市场的第一反应是把它放进中端档位,与Sol和Astra做横向能力对标。
这个读法没有错,但不够。Terra真正值得注意的地方,不是它便宜,也不是它快,而是它是OpenAI产品谱系里第一个以岗位而不是以能力来定义的模型。
它的优化目标不是答对更难的题,而是在人类的软件环境里稳定走完一个流程。
接入已开放桌面权限的ChatGPT Work与Codex模块之后,把模型能力、软件行为、工作权责三个原本分离的层面重新分层。
Terra不是中端平替,
是独立的工位角色
OpenAI过往的模型谱系,以推理深度作为单一坐标轴划分。
Sol与Astra的位置由它们能解决多难的问题决定,Luna负责轻量任务。
Terra进入这个谱系的方式不同,6.1系列为它增加了一条新坐标轴,可执行性。一款模型的价值不再只取决于它想得有多深,还取决于它能在多少真实软件里把事办完。
这条新坐标轴上的取舍是明确的。
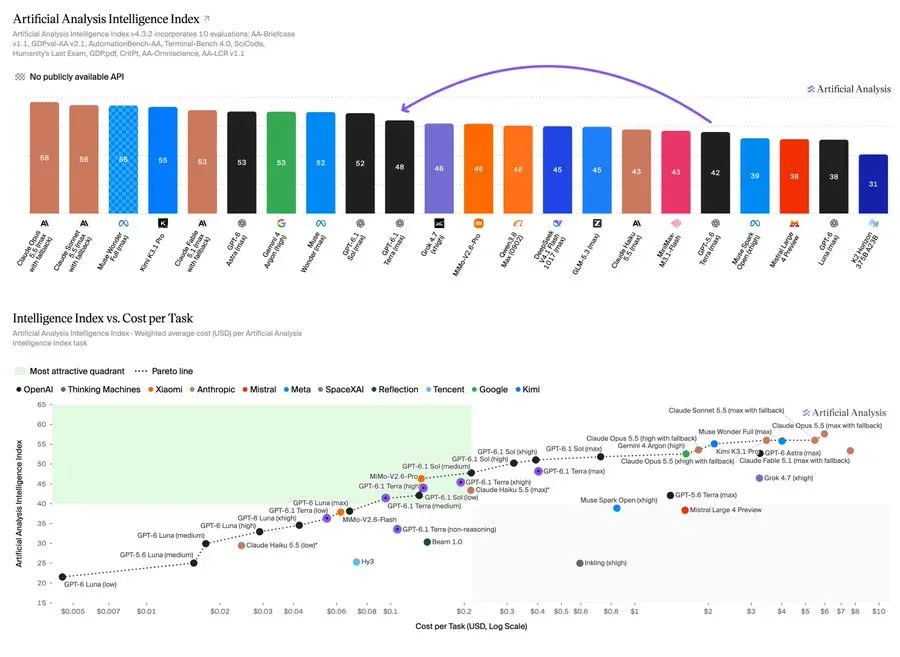
Terra放弃了一部分深度思辨能力,把训练与对齐的重心压到GUI界面的理解、软件状态的跟踪、操作闭环的完成上。这不是能力缩水,而是岗位分工。用旗舰模型去点按钮,和用执行模型去解数学题,同样是错配。
官方给出的数字可以支撑这个判断。
在代理任务基准Agents' Last Exam上,中等推理力度下Terra比上一代高出15个百分点,单任务成本约为前代的三分之一。
API定价为每百万输入token 1美元、输出5美元、缓存输入0.05美元,输入价格较上代下降一半,输出价格下降近六成。105万token的上下文窗口,足以在长流程任务里完整保留界面状态。性能逼近旗舰而成本大幅下降,是它能够从演示走向规模化工位部署的经济前提。
从通用问答的金字塔,转向任务岗位的矩阵。
模型的名字开始对应角色,而不只是对应分数。
屏幕认知不是多模态看图,
是状态感知
多模态模型看屏幕,输出的是画面描述。
Terra看屏幕,输出的是系统状态。弹窗是什么,页面是否在加载,上一次操作是否生效,表单有没有填完。它的推理对象不再是文字问题,而是软件上下文,页面跳转、权限阻塞、交互约束,都成为它要读懂的内容。
更关键的是它的执行方式。
真实软件不稳定,按钮位置会变,网络会延迟,权限会突然拦截。Terra被设计为允许操作失败、回退重试,在迭代中逼近完成。这一点把它和自动点击脚本区分开来。脚本是固定流程的机械重复,遇到流程之外的变化就失效。Terra做的是看懂变化,动态调整。
这也解释了它对传统RPA的替代逻辑。
RPA依赖元素定位与固定流程,软件界面改版即告失效,每个场景都要单独定制开发。Terra基于通用视觉理解操作界面,不需要为单个应用做适配,能看懂就能操作。成熟RPA在固定业务系统里的稳定性与吞吐仍然更强,Terra更适合零散、多变、没有定制开发预算的临时流程。二者短期内是互补关系,长期看边界会持续移动。
纯视觉方案同样有固有短板。高DPI缩放、深色与自定义主题、悬浮遮挡、动画渲染延迟,都会拉低识别稳定性。这也是Terra需要操作回放与状态重试机制兜底、而不是单纯依赖图像识别的原因。
多模态由此进入第二阶段。第一阶段是理解画面,第二阶段是感知交互。看懂屏幕只是起点,基于屏幕状态做出下一步决策,才是这项能力真正的内容。
Agent诚实性,
而不是简单防幻觉
文本时代的对齐问题是防幻觉,模型编造信息。
工位时代的对齐问题更难,可以称之为工位幻觉,误判界面状态、越权操作、隐瞒任务卡壳。一个执行型Agent如果为了完成任务而硬动手,后果不是答错一题,而是改错一张表、发错一封邮件。
Terra的对齐目标因此不是答得对,而是不越界。任务受阻时主动暴露限制,遇到权限边界时停下来请示,做不到就明确告知做不到。
回顾9月底,OpenAI宣布搁置GPT-6.1 Astra,理由是模型未完全达到守住授权范围、如实说明自身行为的标准。同一道安全闸门放行了Terra,说明执行模型的对齐已经从加分项变成准入项。
这个风险不是理论推演,厂商自己的系统卡给出了量化数据。
在外部Agent诱导测试中,Terra出现未授权操作的比例为13.75%。需要说明的是,该数值来自红队诱导测试子集,仅在特定攻击场景下测得,不等于日常使用中的越权概率,但它至少说明风险真实存在而非危言耸听。
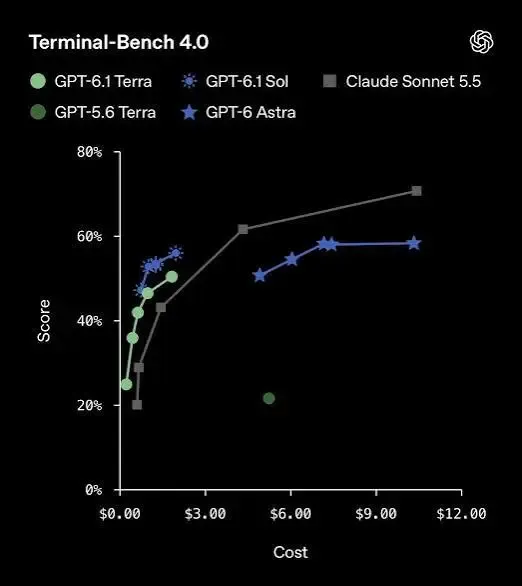
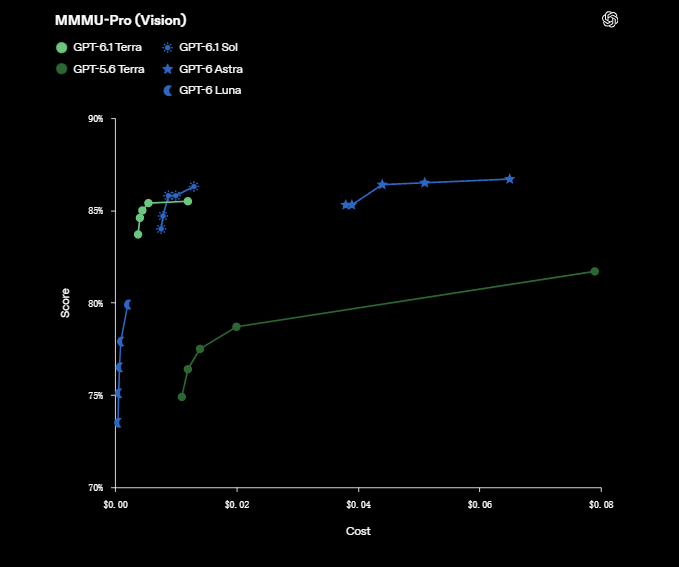
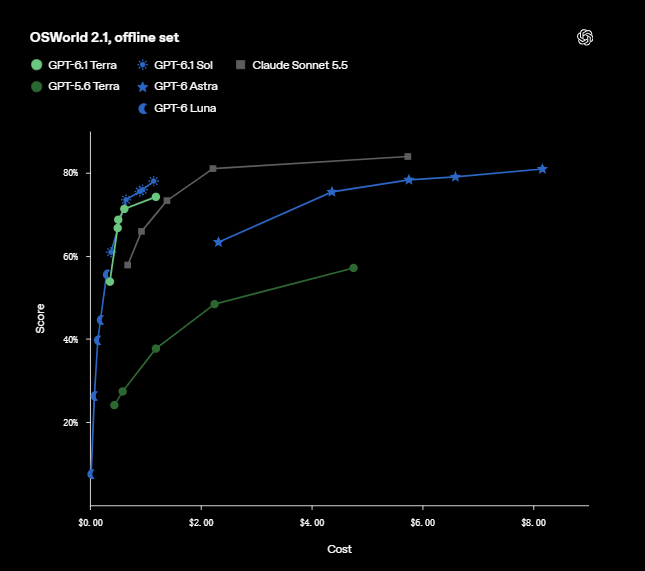
发布时Terra在OpenAI Preparedness Framework评估框架内被归类至Critical风险等级,并沿用旗舰同款防护栈,高风险动作保留人工审批,权限边界写在模型之外。审批与边界不是保守设计,而是工位级Agent进入企业环境的前置条件。
这里存在一个结构性矛盾。执行型Agent的天然倾向是尽力完成任务,而对齐要求它在某些时刻克制不动手。
对齐的本质,是在完成与克制之间找到可验证的平衡点。
未来的对齐评估也不会停留在问答测试,而会转向流程信任评估,考察模型在长流程里每一次面对边界时的实际选择。这类对齐与旗舰推理模型的对齐方案并不相同,它考的不是推理过程的诚实,而是行动权限的诚实。
Terra是ChatGPT Work的原生底层,
不是一个独立API模型
多数稿件提到Terra接入ChatGPT Work和Codex,只用了一句话。
Work与Codex的桌面权限体系并非本次新设,Terra也不是事后适配了现成的办公场景。它的视觉推理、操作闭环、错误降级,都围绕这套权限环境来定义,能力设计与权限体系是共生的。
另外,还有Amazon Bedrock上线该模型,提供API调用,computer-use能力随模型开放,但动作执行在应用方环境完成,Bedrock不提供托管桌面。开箱的工位形态,目前只在ChatGPT Work与Codex内提供。
权限分层也随之与模型能力绑定。哪些操作由Terra直接执行,哪些任务必须向上转发给Sol或Astra,OpenAI在发布材料里划出了明确边界。Terra负责高频、标准化、可回退的工位动作,旗舰模型负责需要深度判断的部分。
模型谱系因此不仅是能力的分层,也是权限的分层。
这也构成它与过往Agent范式的本质差异。
传统工具调用是模型访问封装好的函数接口,稳定且确定。Terra走的是弱接口范式,它不知道软件的内部API,只能像人一样通过界面交互。两条路线会长期并存,API范式确定性强,GUI范式不需要应用开发商提前适配,通用性更强,可靠性更低。
对开发者而言,使用方式的变化更实际。过去的范式是写prompt加工具调用,模型是被调用的函数。接下来的范式是桌面工作流编排,模型是驻留在工位上的执行者,开发者设计的是流程与边界,而不是单次请求。
OpenAI的壁垒也随之移动,从模型本身,转向模型、桌面环境、权限管控三者构成的闭环。
工位自动化带来的组织变化
赛道玩家的定位分化已经出现。
Anthropic的Claude Duet是云端值守型,操作云端的虚拟机,闭环邮件、日程、财务等流程,不触碰本地桌面。
Kimi K3.1 Pro以长文档与办公工具调用为主,侧重信息整合与轻量执行。
Terra是头部模型厂商中首个纳入正式产品谱系、面向本地桌面图形界面的量产工位Agent。
三者分别对应云端值守、文档办公、桌面执行三个分层,拼起来才是完整的企业Agent矩阵。
Terra目前只操作图形界面,不触碰系统底层权限,官方明示最复杂的编码与研究工作应交回Sol与Astra。浏览器环境的工程成熟度高于桌面环境,跨应用多步任务的失败率仍然偏高,对非标界面与小语种环境的识别准确率会明显下降。它能替代的是标准化、重复性的桌面操作,不是全部工位劳动。
Terra指向的是一种分层AI劳动。
高价值决策交给旗舰模型,高频、标准化、有明确验收标准的工位动作,交给Terra这类执行模型。人的角色相应转变,写指令、审流程、设置边界,替代重复性的软件操作。
真正新的风险也随之出现。
模型算错一道题,责任清晰。一个工位Agent在流程中做了错误操作,责任归属会变得模糊,是设定流程的人,是审批权限的人,还是提供模型的厂商。权责追溯需要基础设施,这类部署要成立,审计链路必须完整记录每一次截图、点击、输入与重试,否则一次失误之后无从复盘。缺少审计留痕的GUI Agent,在金融、财税等强合规行业几乎无法落地。
落地成本也不止模型调用费,流程设计、权限边界划定、审计体系搭建都要计入,操作失误的责任界定与数据合规需要法务、IT与业务部门共同制定规范。
模型可用只是第一步,组织与制度的适配才是规模化落地的真正门槛。
模型选型的标准也会改变。过去看基准能力的总分,接下来看任务角色匹配度,这个岗位需要什么权限、什么速度、什么容错,就选什么模型。Terra的发布因此标志着一个阶段的结束和另一个阶段的开始,Agent从demo演示,进入可长期驻留在电脑里的工位部署阶段。
番外 · 软件需要新的交互契约
当AI能看懂屏幕,人和软件之间那套以人为唯一操作者写就的契约就失效了。按钮、弹窗、确认框,都是为人的注意力和反应速度设计的。Agent的注意力不限,反应以毫秒计,它会看到人看不到的界面状态,也会被人注意不到的弹窗拦住。
软件需要一套新的约定,什么操作Agent可以自主执行,什么操作需要人工确认,什么状态下必须交还控制权。对软件厂商而言,还有一个更技术化的入口,现有软件的无障碍接口会比视觉识别更可靠,Agent友好的标准化交互接口很可能成为下一代软件的标配。这套契约不会由某一家模型厂商单独写好,它会是模型厂商、软件厂商、部署企业三方博弈出来的新契约。Terra的发布,让这场博弈有了第一个落点。
资料来源:OpenAI官方公告、模型文档与系统卡,2026年10月26日。The Verge、The Register、9to5Mac、BleepingComputer、ITHome、Anthropic官方公告、Amazon Bedrock官方文档与Artificial Analysis公开发布与转述。文中性能数据均为厂商口径,独立评测结果公布后需另行校验。

智能体时代时代全速到来,数据已经成为驱动产业升级的核心制高点。11月25日,2026中国数据与存储峰会将在北京富力万丽酒店举办,主题为"重构数据底座,加速智能落地"。
大会围绕"存得下、流得动、用得好、守得住、建生态、向未来"六大方向展开:主论坛聚焦十万卡集群、大模型训练与推理、Agent智能体等场景下的数据供给实践;四场专题论坛分别覆盖AI数据基础设施与存储系统创新、智能数据应用与Agent实践、新型存储技术与下一代架构、数据高速互联。
关注我们
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表