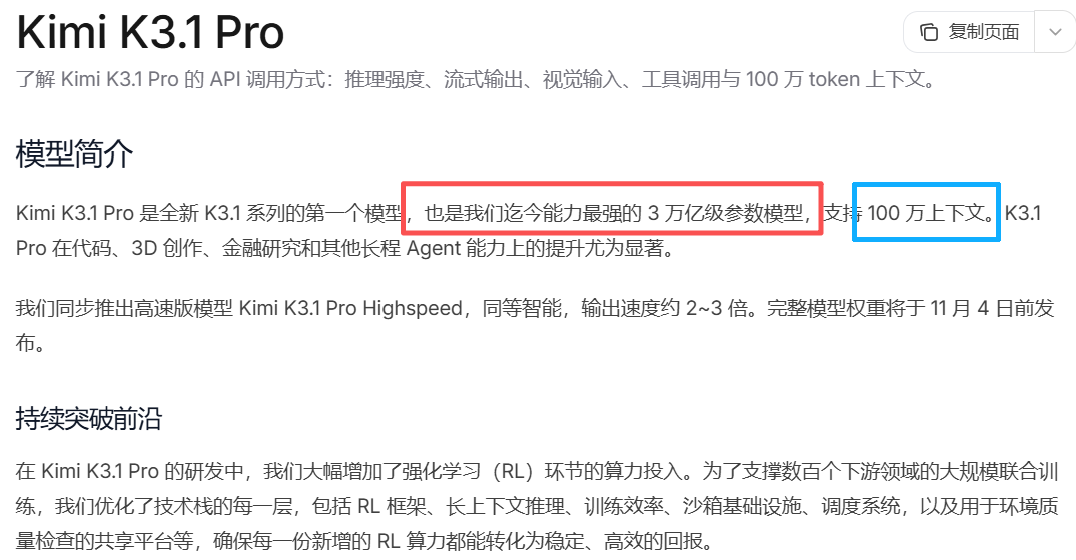
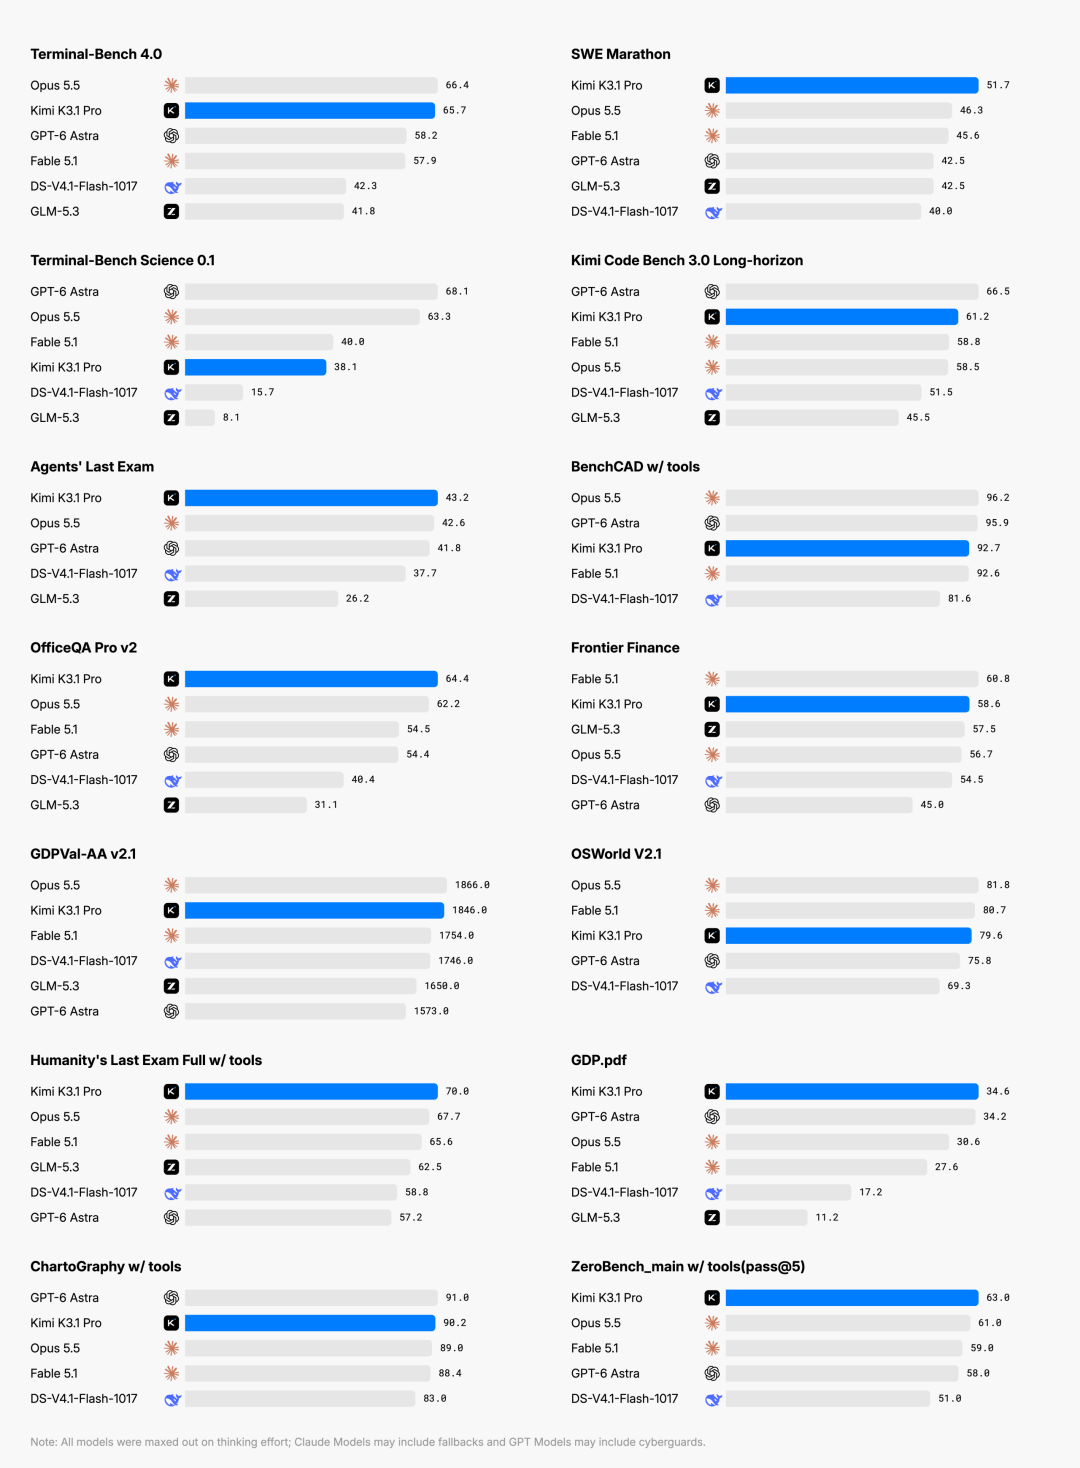
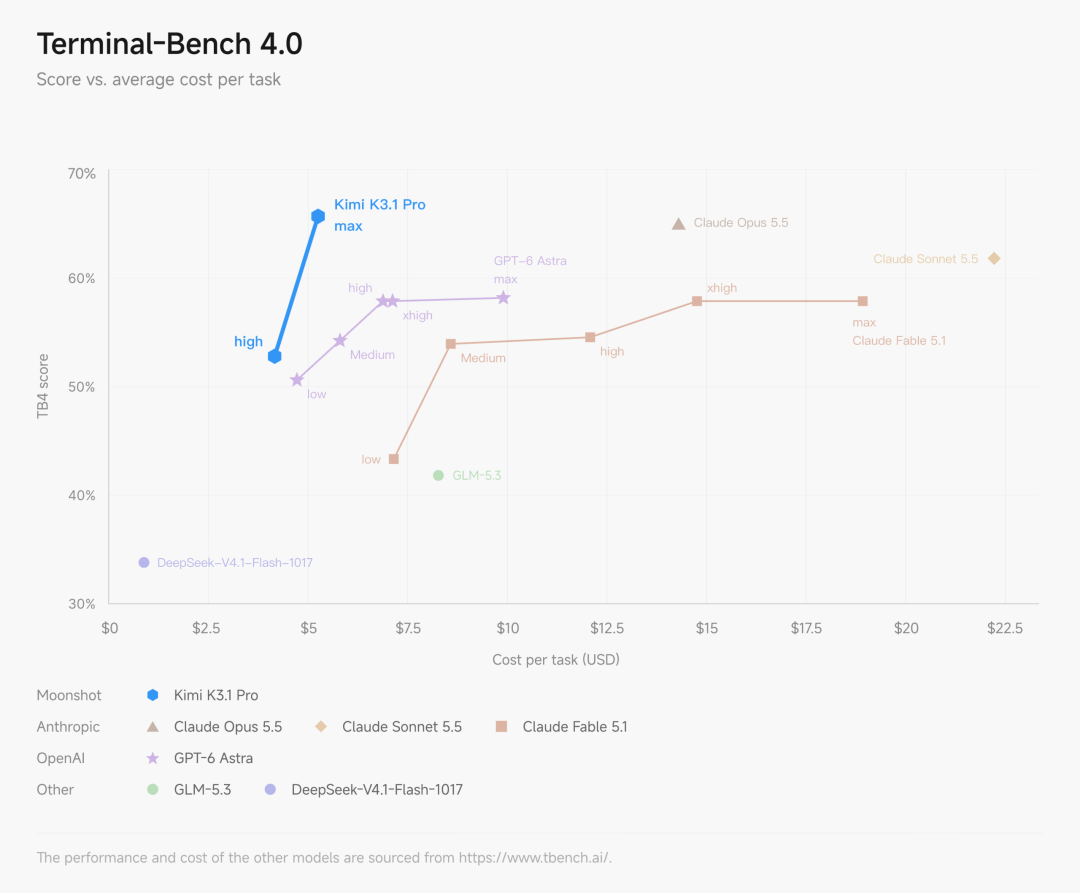
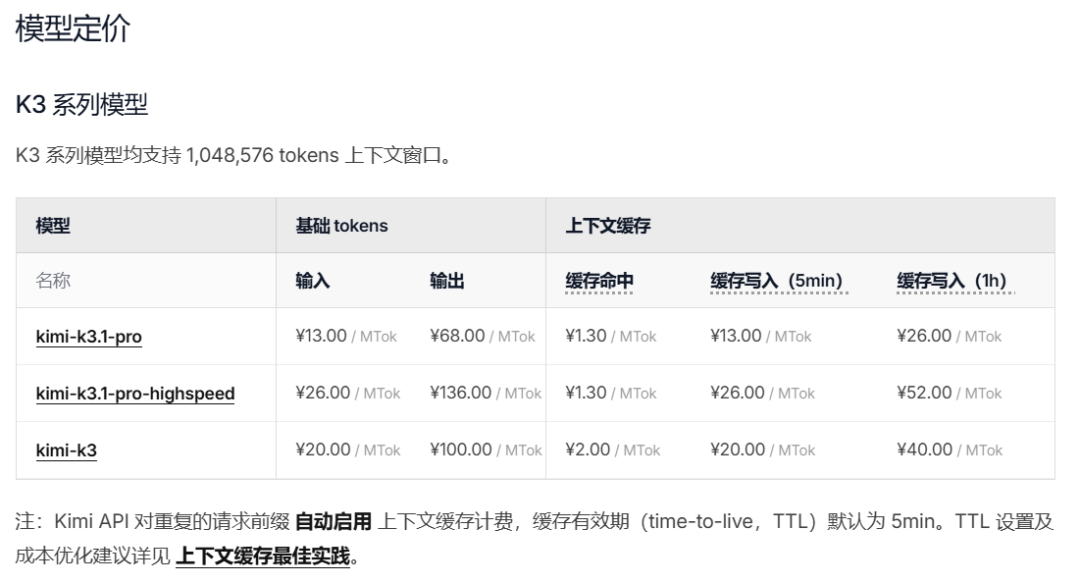
10月24日,腾讯WorkBuddy接入Kimi K3.1 Pro及Highspeed版本,将模型引入研发编码、通用办公和云端托管等工作流。 而就在今天10月26日,Kimi就限流和不必要额度消耗公开致歉,宣布向所有档位、仍在有效期内的订阅会员补偿月度总额度的25%,并披露已调整配置,正在减少不必要的子Agent调用和输出长度。随后,Kimi表示相关用量重置已经完成。 模型接入与额度调整分别对应能力交付和运行时治理。K3.1 Pro的技术评估因此不能局限于参数与基准分数,还需考察后训练方法、长上下文状态管理、工具调用轨迹和子Agent编排如何共同影响任务成功率与资源消耗。 K3.1 Pro是在K3基础上进一步后训练的版本,升级重点是更大规模的多领域联合强化学习及长程Agent能力优化,而非重新训练一个独立底座。 模型总参数约2.8万亿,采用混合专家架构,单次前向计算激活约1040亿参数,支持100万Token上下文。总参数、激活参数与上下文窗口分别描述模型容量、单Token计算路径和可处理信息规模,三者均不能直接换算为Agent任务成功率。 官方文档显示,K3.1 Pro大幅增加了强化学习环节的算力投入,面向数百个下游领域开展大规模联合训练,并配套优化RL框架、长上下文推理、训练效率、沙箱基础设施、调度系统和环境质量检查平台。 长程Agent的后训练对象不只是单轮文本,而是由规划、工具调用、环境反馈、错误恢复和结果验证构成的执行轨迹。 奖励信号往往延迟出现,中间步骤又可能改变后续状态,训练环境有效性、轨迹采样质量与奖励设计由此成为算力转化为能力的关键条件。 官方测试中,K3.1 Pro在Terminal-Bench 4.0取得65.7%。该基准通过资源受限的真实终端任务检验编程Agent,按任务是否通过完整验证测试计分,不提供部分通过得分。 K3.1 Pro在内部Kimi Code Bench 3.0 Long-horizon中得分61.2%,高于K3的55.95%。后者重点考察多步执行、工具调用与端到端问题解决,较能对应本次后训练的能力方向,但内部结果仍需与第三方评测分别引用。 在另一组刻意选取高难度易错样本的去标识化压力测试中,官方披露的单项事实陈述错误率由K3的23.35%降至6.85%。该数据反映特定困难样本上的改进,不代表日常请求的整体错误率,也不能替代对长任务事实一致性的独立测试。 K3.1 Pro在API层始终开启思考模式,支持low、high、max三档推理强度,默认值为max。 流式响应分别返回推理增量与最终答案增量。推理强度提高可能扩展复杂任务的搜索深度和错误恢复空间,也会增加解码Token数量与生成时延。 API配置不能直接等同于订阅产品的内部策略,但其运行方式说明推理长度已经成为模型能力与资源消耗之间的显式变量。 Highspeed版本的“约2至3倍”指输出速度,主要作用于自回归解码阶段,对交互式低时延场景的价值较为直接。 完整Agent任务还包括提示词预填充、工具执行、外部等待、结果验证和失败重试,端到端提速取决于解码耗时在整条执行链中的占比。该指标不涉及模型智能或推理强度下降,也不能据此推导单任务成本降低。 长上下文的资源开销还需区分权重、计算与运行状态。K3.1 Pro是K3的后训练版本。 K3公开资料显示,其采用KDA与MLA混合注意力。 KDA(Kimi Delta Attention)是月之暗面提出的线性注意力机制,其递归状态规模不随序列长度增长,避免了相应层级的逐Token KV缓存累积。KDA与周期性MLA层共同构成这一架构,为控制百万上下文状态开销提供了重要基础,MLA层缓存则随Token累积。 因此,不能按照传统全注意力模型简单推算其百万上下文显存占用,更不能将KV缓存规模与MoE总参数量直接绑定。高并发场景下的实际压力取决于状态驻留、序列构成、前缀复用和调度效率。 官方上下文缓存提供5分钟和1小时两档TTL,通过复用稳定前缀减少重复计算,但缓存并不等同于语义压缩。多轮工具调用仍需回传完整assistant message并追加工具结果,动态加载的工具定义也要保留在后续历史中。 随着轨迹延长,推理记录、调用参数和工具输出会持续进入上下文。若缺乏摘要、裁剪和选择性检索,重复预填充与低信息密度Token处理将随之增加。 上下文容量也不等于全位置等效利用。既有研究在部分模型和任务中观察到位置敏感现象,中间位置信息的检索与推理效果可能弱于首尾位置。一般性局限说明长上下文仍需检索、重排与压缩机制配合,但目前没有证据将其与Kimi此次额度异常直接关联。 多Agent架构可以通过任务分解、上下文隔离和并行执行处理复杂问题,也会引入额外编排成本。 每个子Agent可能携带独立提示词、工具定义和运行状态,主Agent还需读取汇总结果并执行一致性检查。总Token消耗由主Agent轨迹、子Agent扇出、工具结果回灌、上下文复制和失败重试共同决定。缺乏调用必要性约束时,并行度提高可能同时放大计算消耗与额度扣除。 Kimi公告没有披露具体子Agent架构或任务分级算法,因此不能将此次调整进一步描述为某种固定三层结构。已确认的信息仅限于配置调整、减少不必要的子Agent调用和输出长度,其技术指向是控制无效轨迹与冗余生成,而非已经证实的模型权重缺陷。 Artificial Analysis的最新测试显示,K3.1 Pro完成其智能指数任务时平均输出约5.5万Token,较K3增加约14%。每项任务成本约2.11美元,与K3约2美元接近。 Token单价、输出长度和任务成功率属于不同变量。能力更强的模型若通过更充分的推理减少失败和人工返工,增加的有效消耗可能具有合理性。未转化为成功率的重复规划、无效调用和冗余输出,则构成需要治理的成本。 按照公告,补偿以已消耗用量为处理对象:会员获得月度总额度25%的补偿,当前已用量不足25%的账户将已用量清零,并非将剩余额度归零。额度重置处理账户核算,不能单独证明推理链路已经优化。 后续效果需要由运行时数据验证,包括同类任务的平均Token消耗、子Agent调用次数、失败重试率、缓存命中率、限流发生率及端到端时延。 输出压缩和子Agent削减还需接受成功率约束:若过度缩短推理轨迹或压缩工具信息,资源消耗可能下降,长任务完成质量也可能受到影响。 WorkBuddy接入扩展了K3.1 Pro的任务执行边界,额度调整则呈现了长程Agent规模化服务中的运行时约束。对这类模型的有效评估,应建立在任务成功率与资源消耗的联合指标上:既考察模型能够完成什么,也考察完成同一任务需要多少推理、调用、等待与重试。后训练扩展:优化对象由回答转向执行轨迹
推理成本:思考模式、混合状态与前缀缓存
子Agent治理:控制无效轨迹而非单纯压缩输出
以任务单位指标检验修复效果
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表