
2026年10月18日,第二十二届CCF全国高性能计算学术大会在深圳开幕。
展台上最吸睛的是三台机器,装进一栋楼的十万卡超集群曙光8000,靠全CPU架构登顶TOP500的灵晟,以超节点破内存墙的鲲鹏。
但如果只看见机器,就看轻了这届大会。它真正摆上台面的是一把正在换代的尺子。
先记住三个数字。
10万
全国产十万卡AI超集群曙光8000真机首次公开亮相,此前已支撑十大前沿应用。
50千瓦/平方米
十万张卡压缩进2000余平方米机房的单位面积热负荷,行业测算值,是传统数据中心主机房1至2千瓦/平方米量级的数十倍。
90%以上
十大应用中万卡级任务的弱扩展效率下限,壁湍流模拟达98.64%,超声速射流求解器超过99%。
这三个数字分别对应三个问题。
装得下吗,散得掉吗,一起算得动吗。
过去行业的宣传口径只回答第一个问题,现在后两个问题成了主战场。
从多少P到每平方米多少千瓦
中美都号称在造十万卡集群,但造法完全不同。
美国AI巨头的同类设施热衷于算力小镇,占地动辄上百万平方米。曙光8000则把十万张卡装进郑州北龙湖畔一栋建筑,13340个计算节点、1500吨主机、1600公里内部线缆,全部收敛在约0.05毫米的组装精度之内。
而高扩展效率的底气,有一半藏在看不见的地方。
自研scaleFabric 400G无损网络,单子网可支撑超11万卡部署,端到端时延压到0.93微秒。这组漂亮的效率数字有一个前提,同构芯片、单域无损网络、不做跨机房调度。一旦跨地域组网,网络拥塞会直接拉低并行效率,这恰恰是全国一体化算力网络最难落地的卡点。
散热这一关由浸没相变液冷接住,整机PUE低至1.04,高密度机房里供电与冷却的基建投入已超过加速卡采购成本本身。芯片决定算力的上限,电冷网决定算力能兑现几成。
三条路线同台,第一次把架构取舍摊开在公众面前。
曙光8000走国产异构,兼顾AI大模型训练与流体、材料类科学仿真。
灵晟以2.198 EFlops持续双精度性能登顶TOP500并摘得HPCG冠军,主打FP64科学计算的硬核回归,其应用成果XLSDFT同时入围2026年ACM戈登贝尔奖决选。

鲲鹏超节点以4096节点组网、内存统一编址削减数据搬运,优先面向长上下文的智能体推理。
方向不同,终点相同,超智融合已从口号变成各方殊途同归的架构共识。
有效算力取代峰值算力
扩展效率不是抽象指标,它对应的是具体科学问题被解决的速度。
4万亿暗物质粒子的宇宙演化模拟,接近量子力学精度的万亿原子分子动力学,世界首个千亿神经元数字孪生脑,全球首个1公里分辨率全球海洋环流预报,十大应用的清单里,这类过去算不动、现在以周计的问题占了大多数。
峰值算力回答能不能算,扩展效率回答能不能一起算得动,后者才对应科学家真实的排队时间。
细拆这套效率,它是三个维度的合谋。
计算的弱扩展效率,网络的无损传输,以及常被忽略的存储IO,曙光8000的自研存储拿下了2026全球IO500生产型全节点与10节点双榜第一。芯片网络存储,缺一个维度,万卡规模都会变成昂贵的摆设。
更值得记录的是负载结构的变化。
集群上线首周即满载,日均作业超15万个,这些作业里既有大模型训练与高通量推理,也有科学计算与工业仿真。科学仿真与AI负载在同一张网上并行,已经成为十万卡集群的日常,纯大模型训练不再是唯一主力。

算力评价指标正在经历三层演进,从只看HPL峰值浮点,到引入HPCG与弱扩展效率,再到加入IO500存储吞吐、单位Token能耗、单位千瓦产出。
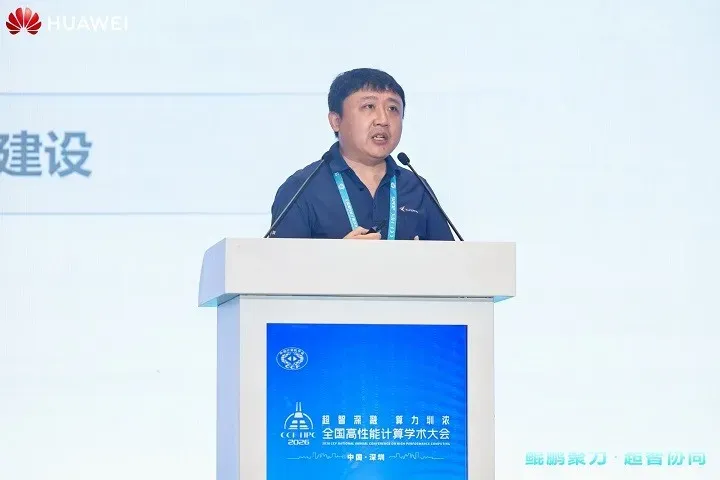
大会特邀报告中,学界明确提出要构建面向大语言模型与智能体时代的综合HPC评价指标。华为鲲鹏专场的判断更进一步,智能体驱动下推理算力占比持续抬升,2026年有望达70.5%,算力评估不再只看浮点,还要看单位Token的能耗与成本。
厂商与学界从两头逼近同一个结论。当评价体系的研究者开始讨论换尺子,旧尺子的时代就真的接近尾声了。
这组数据同时校正了算力过剩论。核心节点接近满载,科研团队仍在排队,而大量通用机房上架率不足。缺的从来不是机架,而是高密、液冷、可被统一调度的机架。结构性错配,才是当前算力供需的真实图景。
从可用到好用是更难的一关
国产替代的下半场是生态替代。
国产电子产品的仿真平台不改一行源码即可在核心节点完成迁移。累计近千项超算与智算融合应用深度适配,覆盖30多个科研与产业领域,300余项重点应用完成深度优化,其中20余项实现整机运行。
比适配更深一步的动作在工具端。中科曙光在大会期间同步展示了OneScience科学大模型开发平台与科学计算智能体,目标是让高校、科研机构与产业用户不必触碰底层,也能把万卡算力用起来。适配解决迁得过来,工具解决用得起来。
经前期多轮专家研讨,新时代超算产业协同发展行动计划在本届大会正式对外发布,并配套推出超智协同开放社区,面向开发者与科研机构开放软件栈、模型与基准测试集。
行动计划回答怎么协同,社区就是协同的载体,瞄准的是国产异构生态各自孤岛的老问题。单点系统的竞赛已经打完,接下来比的是体系。
1、核心节点的接近满载是高强度科研负载的样本,不能外推为全行业景气度。
2、生态普惠仍有代价。不改一行源码目前还是少数被重点扶持应用的待遇,大量自研工业仿真代码仍需重新编译调优,从可用到好用,还需要几个版本的迭代周期。
3、生态普惠仍有代价。不改一行源码目前还是少数被重点扶持应用的待遇,大量自研工业仿真代码仍需重新编译调优,从可用到好用,还需要几个版本的迭代周期。
十年前,衡量一座数据中心的标准是机柜数量。五年前,是PUE。今天,是每平方米能装下多少千瓦,万卡并发能兑现几成效率,每度电能产出多少Token。计量单位的每一次迁移,都是能力坐标系的一次重设。这届大会真正发布的,是这张新的坐标系。而它对中国算力产业的要求,远比再造几个十万卡更高。
算力“芯”动向 · 专注AI与算力产业观察 今日参考阅读文章: (1)从宇宙深处到田间玉米 国家超算互联网十大前沿应用正式发布 (链接:https://m.sohu.com/a/1089523998_121443915?scm=10001.325_13-325_13.0.0-0-0-0-0.5_1334) (2)2000平方米与十万张卡:算力密度正在重写建筑的尺度 (链接:https://www.qianjia.com/html/2026-10/19_428095.html) (3)中科曙光发布曙光8000十大前沿成果 300余项应用完成优化 (链接:https://www.guandian.cn/article/20261018/614648.html) (4)记者探访全国首个十万卡AI算力集群 算力密度世界罕见 (链接:https://www.21jingji.com/article/20261019/herald/e95eb65f077a4dbbc5bf39b91b8babde.html) (5)世界算力博览会深圳举行,刷新全球算力新高度的“灵晟”受关注 (链接:https://www.sohu.com/a/1089383235_121010226?scm=10001.325_13-325_13.0.0-0-0-0-0.5_1334) (6)“鲲鹏”亮相第二十二届全国高性能计算学术大会 (链接:https://www.sohu.com/a/1089386017_121010226?scm=10001.325_13-325_13.0.0-0-0-0-0.5_1334) 本文若有歧义欢迎读者分享指正。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表