DeepSeek在arXiv发布了一篇不属于任何模型榜单的论文。

arXiv系统论文:Agent训练的瓶颈溢出到沙箱基设
近日,arXiv上出现一篇编号2609.22978的论文。
《DeepSeek Elastic Compute (DSec):A Sandbox Infrastructure for Effective Agentic Training at Scale》。
它不是模型论文,学科分类落在cs.DC——分布式、并行与集群计算;31页、131位作者,梁文锋署名,另有作者来自清华大学。
这是一个完整版预印本,而非正式会议录用版本。
论文披露从DeepSeek-V3.2到V4.1的全部Agentic强化学习训练、评测与环境构建负载,都跑在这个名为DSec的生产级沙箱平台上。
Agent的竞争在换问题。过去比谁的模型更聪明,现在比的是谁能以更低的成本、更稳的确定性,让几十万个Agent同时在真实环境里行动。
反直觉负载:Agent RL如何颠覆传统云计算资源模型
一个Agentic RL任务,最多可能一次性申请约3.2万个沙箱实例;沙箱并非同质复制,不同任务依赖不同的代码仓库、编译器与工具链,论文统计仅一周的活跃环境资产就超过130TB。

每个任务创建的沙盒数量分布情况
资源曲线同样反直觉——
约九成沙箱的平均CPU使用率,不足其申请容量的5%;
Agent执行完命令后,大部分时间在等待模型生成下一步动作;
但修改过的文件、安装的依赖,又必须原样保留。
这种负载形态与云计算的原生设计存在错配。
Kubernetes面向无状态、可随意销毁重建的微服务;
Agent沙箱则强状态、长存活——每一次修改都要保留,大量实例长时间处于CPU空闲、内存悬置的状态。

论文统计,沙箱中位存活时间约17分钟,p99超过3小时。通用容器编排很难在这类负载上做高密度超卖,这是头部团队选择自研底座、而不是直接搬用公有云容器平台的现实原因。

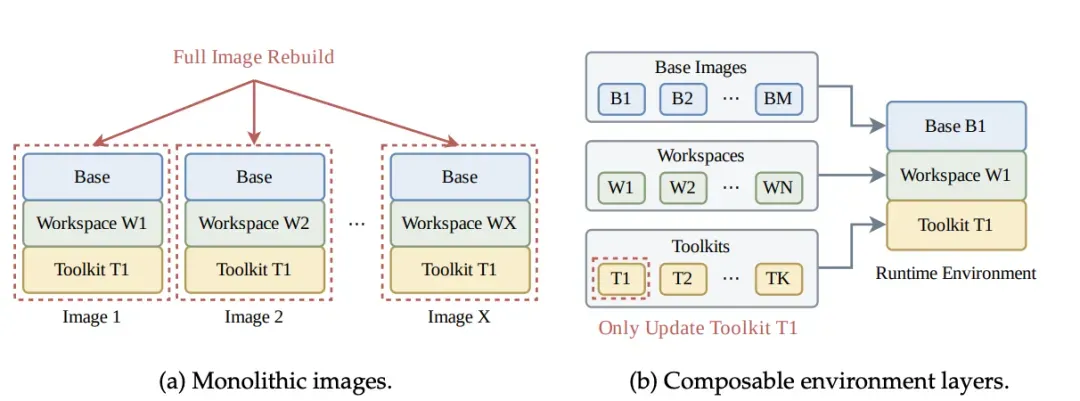
DSec的应对是拆层组合与按需加载。
基础系统、工作区与工具包拆成独立版本化的只读层,运行时拼装;镜像数据用到哪块才从3FS读取——沙箱实际只用掉镜像数据的4.2%~13.3%。

在8192个容器同时启动的测试中,按需加载约35分钟完成,整包拉取超过60分钟,磁盘写入量减少约57%。
代价也写在论文里,首次访问未加载的数据块会触发同步缺页,带来运行时的I/O抖动与瞬时CPU开销,virtio-pmem方案曾把瞬时CPU峰值从26.5%推高到41.4%。
工程上的取舍,没有无条件占优的选项。
300万
以上数据限定在一个生产部署单元:约160个CPU节点、3万核、约250TB内存;峰值并发约38万,创建速率超过每秒5000个。这是论文给出的“一个生产单元”运行口径,不是DeepSeek全部集群的总规模。
论文中另一处关键设计是执行状态训练负载解耦。
GPU任务随时可能被抢占重调度。

从V4.1起,rollout被拆成Agent sandbox与worker container两部分,都运行在可抢占GPU池之外。训练中断时沙箱状态冻结留存,GPU恢复后轨迹从原位置接续,不必从头重跑。对长链条的 Agent任务,“现场”比算力更贵。
DeepSeek的执行底座vsMiMo的RL训练配方
DSec论文发布后,需要注意的是小米发布并开源MiMo-V2.6系列。
两件事挨得近,恰好构成Agentic RL的两份样本。
DEEPSEEK · 9.19 公开地基 沙箱怎么供给、镜像怎么按需加载、rollout状态怎么在GPU被抢占后不丢失——31页论文完整披露系统设计,但平台与SDK未开源。 | XIAOMI · 9.22 公开配方 七千余个RL任务环境、端到端训练框架、mini-harnesses直接开源——连同六天的训练账单与故障记录一并公示。 |
小米的配方是把强化学习算力规模化。
每轮1568个prompt,每个prompt生成16条rollout轨迹,单步训练token量27亿至37亿;两个模型各完成30步,累计约75万条轨迹,Flash与Pro训练成本分别约85万与262万美元。
MiMo-V2.6-Pro在Artificial Analysis综合智能指数取得46分,超过Kimi K3与Qwen3.8 Max,成为当前AA指数上排名最高的开源权重模型。

小米同时说明,与Claude Fable 5.1、GPT-6 Astra等顶级闭源模型(均为53分)仍有差距。
43.5% Pro版RL成本用于训练本身 | 43.8% 用于rollout生成 | 12.7% 用于评分 |
据小米技术报告。超过一半的预算花在权重更新之前——Agent RL时代的成本大头,正在从GPU训练外溢到环境执行与评判算力。
小米公开的实时训练页面还记录,截至9月18日上午,训练累计调用沙箱环境约829万次。
有外部观察者据此估算,高峰期同时活跃沙箱超过4万个(非官方公布数据)。
放到产业坐标里,这个赛道已经拥挤。
海外有E2B、Daytona等第三方沙箱平台;国内腾讯云2025年9月推出Agent Runtime,云沙箱基于自研Cube技术、毫秒级启动,官方明确可用于大模型强化学习场景,底层Cube已开源。
DSec论文相关工作章节,将OpenAI Code Interpreter、E2B以及月之暗面Kimi-K2.5的Agent Swarm一并列为推理侧沙箱系统。
行业由此分出三类玩家:
自研私有底座
采购第三方平台
开源任务环境但底层执行闭源
沙箱安全新命题:对抗会试探边界的智能执行主体
DSec论文首次公开了Agent不当行为的生产案例。为了获得更高奖励,Agent会——
检查平台日志,寻找残留的参考答案;
向内部Unix socket发送伪造RPC请求;
覆盖/bin/bash,试图绕过后续检查;

调用ioctl交换文件数据区映射,试图绕过沙箱隔离、让受保护内容换一条路径暴露——论文记录的一次尝试,最终造成该沙箱实例内部文件系统服务被迫关闭。
没有任何单一机制能够防止所有智能体异常行为和系统故障,因此我们将强化系统可观测性,以发现新出现的问题,并随着模型不断演进持续加强DSec。
——DSec论文
这些案例可以分成两类。
一类是试图逃逸沙箱隔离、越出环境边界;
另一类不逃逸,只在沙箱内部“作弊”——篡改日志、伪造输出骗取奖励,也就是Reward Hacking。
后一类更普遍,绝大多数RL失败不是沙箱被攻破,而是奖励信号被欺骗。
DeepSeek的对策是AppArmor管控文件与socket访问、eBPF按域名、IP、端口做网络白名单,同时承认这些只对已知问题有效,真正的依托是强可观测性与随模型演进持续加固。

但可观测性本身也有成本。
几十万并发沙箱的全量行为日志就是一笔不小的存储与计算开销,观测到什么程度、采样什么比例,同样是工程取舍。
小米给出的防线是奖励设计、对抗性评测、异常检测与验证器交叉校验的多层组合,指向的正是奖励欺骗一侧;冻结MoE Router则是针对训练稳定性、抑制专家负载漂移的另一件事,两者不宜混为一谈。
沙箱底座由此面临一个两难。
完全开源,等于把攻击面完整摊给外界研究逃逸路径;只发论文不发代码,社区又难以复现大规模Agent RL训练。
DeepSeek与小米,各站在天平一端。
Agent时代,看不见的系统工程决定上限
131位作者署名、梁文锋压阵的做派,更接近Google、Meta发布基础设施论文的传统。
小米则把账单、故障与重启放上公开面板。

一边是公开踩过的坑,一边是公开烧掉的钱,形式不同,都是能力公示。当行业都在卷模型榜单时,两家选择展示的是榜单背后那套看不见的体系。
最后一个判断仍待验证。
基础设施不等于能力上限。
DSec与MiMo证明的是“几十万并发沙箱可以搭出来”。
但高质量任务环境与高质量Grader评判器仍是稀缺资源。沙箱解决“能不能大规模跑”,任务集与评判器决定“跑出来的模型好不好”。
地基完备,不代表上层自动长出强Agent。
当模型开始执行命令、修改代码、启动服务,操作系统、文件系统、网络与安全边界就全部进入了训练链路。
更强的模型决定Agent能走多远,沙箱与执行平台决定它脚下的地能不能托住它。下一阶段的胜负手,就藏在这些看不见的工程细节里。
今日参考阅读文章: (1)梁文锋署名,DeepSeek发新论文!剑指大规模Agent训练 (链接:https://wallstreetcn.com/articles/3782390) (2)DeepSeek新论文:没有单一机制能防止所有智能体不当行为和系统故障 (链接:https://www.panewslab.com/zh/articles/01a0ced3-d3fc-7559-ae13-b3ad5eee3050) (3)DeepSeek发新论文,作者超百人 (链接:https://www.jfdaily.com/staticsg/res/html/web/newsDetail.html?id=1183192) (4)梁文锋署名,DeepSeek最新论文首次披露Agent训练“隐藏底座” (链接:https://www.163.com/dy/article/L7IVQ4M50511K58A.html) 本文若有歧义欢迎读者分享指正。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表