过去20多年,CDN通过将内容缓存到靠近用户的网络节点,让全球用户能够畅快地访问网站、观看视频,本身已经是很成熟的老技术了。如今,随着生成式AI应用快速普及,CDN从传输图片、视频变成了传Token,于是便迎来了一次重要的技术变革。

在2026腾讯全球数字生态大会上,腾讯云边缘平台产品架构总监胡兵发表了题为《让AI创新发生于用户最近之处》的主题演讲,详细介绍了介绍了面向AI场景的边缘推理解决方案。依托EdgeOne全球边缘网络,腾讯云希望将网络加速、GPU算力调度、应用部署和推理优化整合到统一的平台中,让AI推理能够更快响应全球用户。
AI推理面临新挑战:模型、流量和业务都在变化
过去两年,AI行业主要关注模型参数规模和模型能力。但随着AI真正进入生产环境,影响用户体验的因素越来越多,例如,网络延迟、算力调度、GPU资源利用率,以及整个推理系统能否及时响应业务变化,都很重要。
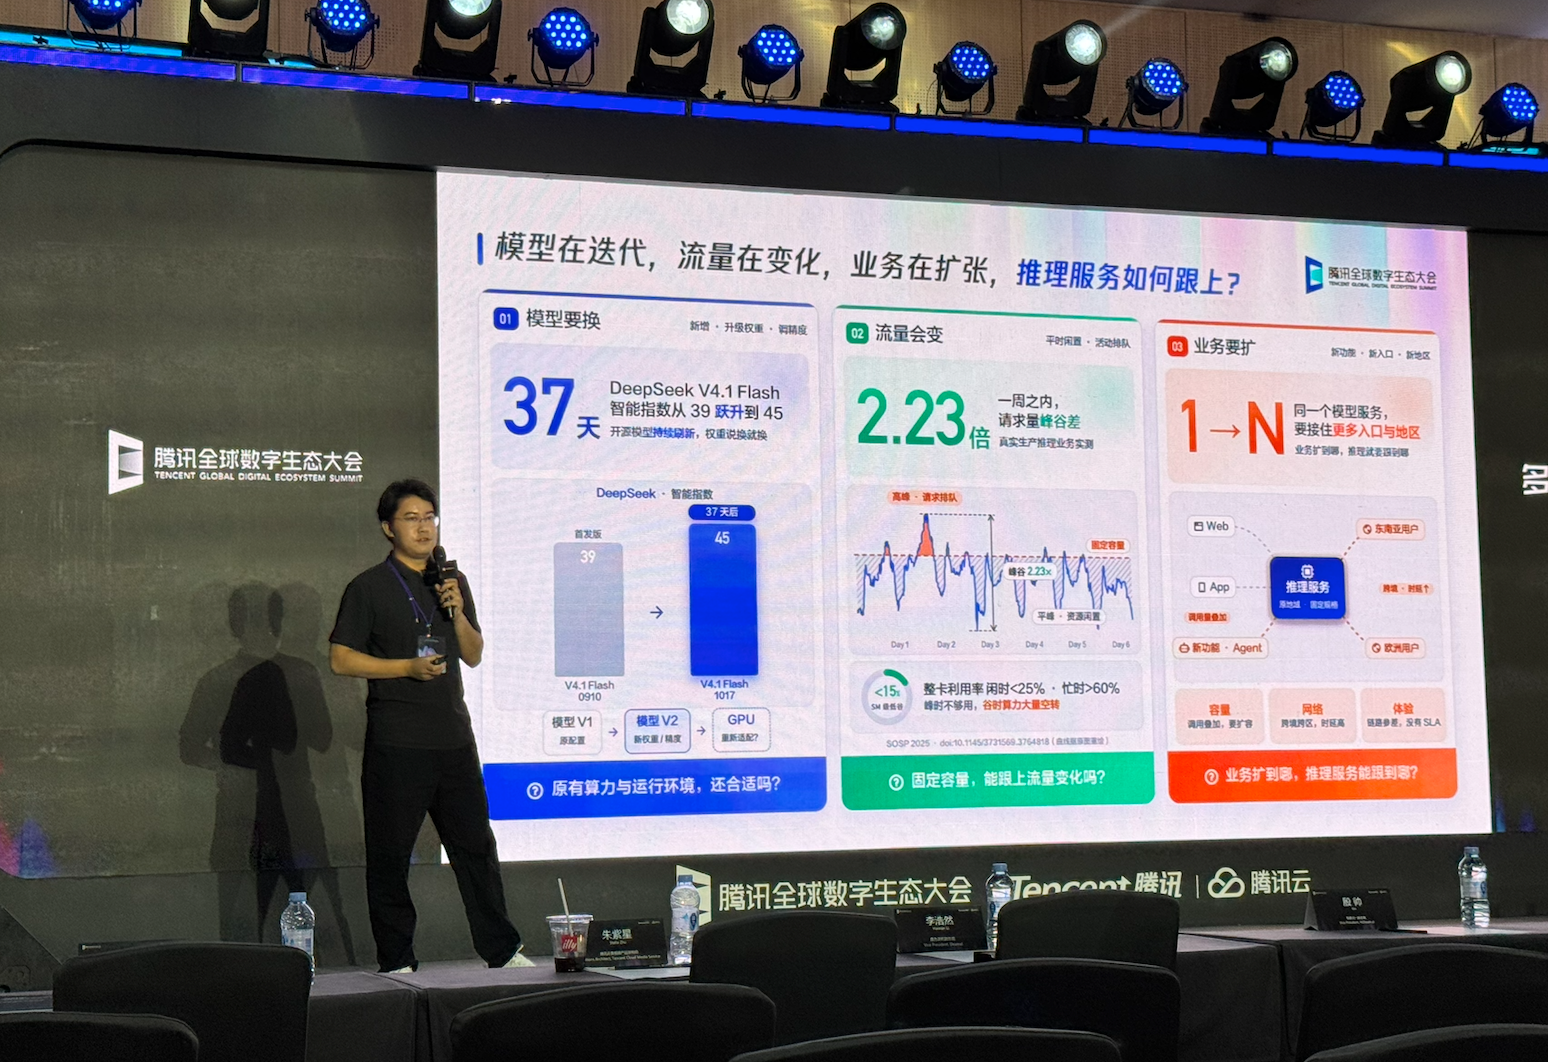
首先,当模型迭代速度越来越快。模型更新后,企业可能需要重新选择GPU、调整推理框架,甚至重新进行性能优化。
其次,业务流量具有明显的波动性。胡兵在演讲中引用的研究数据显示,某真实业务一周内的流量波峰波谷差达到2.23倍,而GPU的实际利用率长期不足15%。这意味着,如果企业按照流量峰值准备GPU,平时就会出现大量算力闲置;如果按照平均流量配置资源,高峰时期又容易出现请求排队。
与此同时,AI应用的服务范围也在扩大。从最初的Web应用,到移动App、AI Agent,种类更多元。地域分布上还会到欧洲、东南亚等全球市场,用户分布越来越广,对网络和算力的要求也更加复杂。
模型在不断更新、流量在波动变化、业务在不断扩张,但大量AI推理系统仍然采用相对静态的资源配置方式,这种矛盾正在成为AI应用规模化落地的重要障碍之一。
离得最近的GPU节点,不一定是最快的节点
胡兵认为,传统AI推理架构存在一个容易被忽略的问题:网络调度和GPU算力调度经常是相互独立的。传统CDN主要根据用户位置、网络链路质量和边缘节点负载进行流量调度,而GPU调度系统则负责管理推理请求、计算队列和缓存。
问题在于,两套系统通常无法充分共享状态信息。CDN知道用户在哪里、网络是否拥堵,却不知道GPU是否繁忙、推理队列有多长。GPU调度系统了解自身的计算负载,却不一定知道用户的网络状况。
结果就是,两套系统各自实现了局部最优,却未必能够实现整体最优。
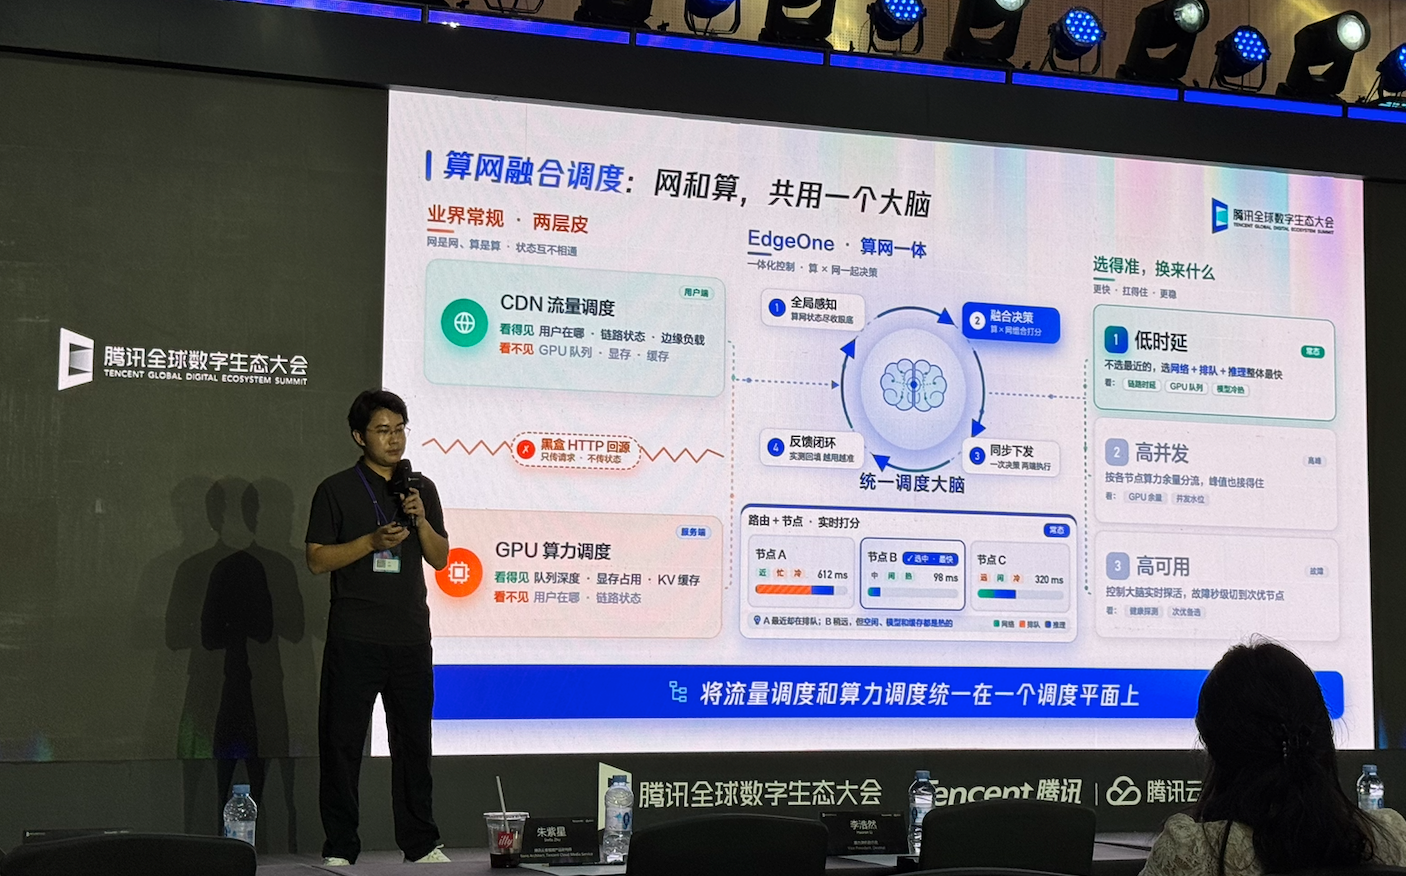
胡兵举了一个例子:假设用户附近有A、B、C三个推理节点。A节点距离用户最近,但排队严重。C节点距离稍远,却有空闲算力。如果只考虑距离,请求会被发送到A节点。但如果综合考虑多个因素,C节点反而可能更快完成推理。
因此,在AI推理时代,距离最近不等于响应最快。腾讯云EdgeOne采用的思路,是将CDN流量调度与GPU算力调度纳入统一控制平面。通过同时感知网络状态、GPU负载、请求队列和缓存情况,平台能够综合判断网络路径、选择哪个GPU实例处理。
这意味着,网络选路和算力选点不再是两个独立步骤,而是一次综合决策。平台还可以根据实际执行结果持续优化调度策略,并在节点故障时快速切换服务节点,提高业务连续性。
这一变化使得CDN的作用不再局限于网络传输,而是进一步参与AI推理任务的资源分配。
从网络到GPU,腾讯云构建一体化推理平台
为实现这一目标,腾讯云EdgeOne构建了一套覆盖网络接入、应用部署和GPU推理的完整服务体系。
在网络层面,EdgeOne拥有覆盖全球的3200多个边缘节点,分布于70多个国家和地区。这些节点过去主要承担静态内容分发、动态网络加速等任务,如今则成为AI推理服务的重要网络基础设施。
与传统CDN不同,生成式AI输出的Token通常需要实时计算,难以像图片、视频一样提前缓存。因此,网络需要重点保障请求的快速接入、流式输出的稳定性,以及长连接服务的连续性。
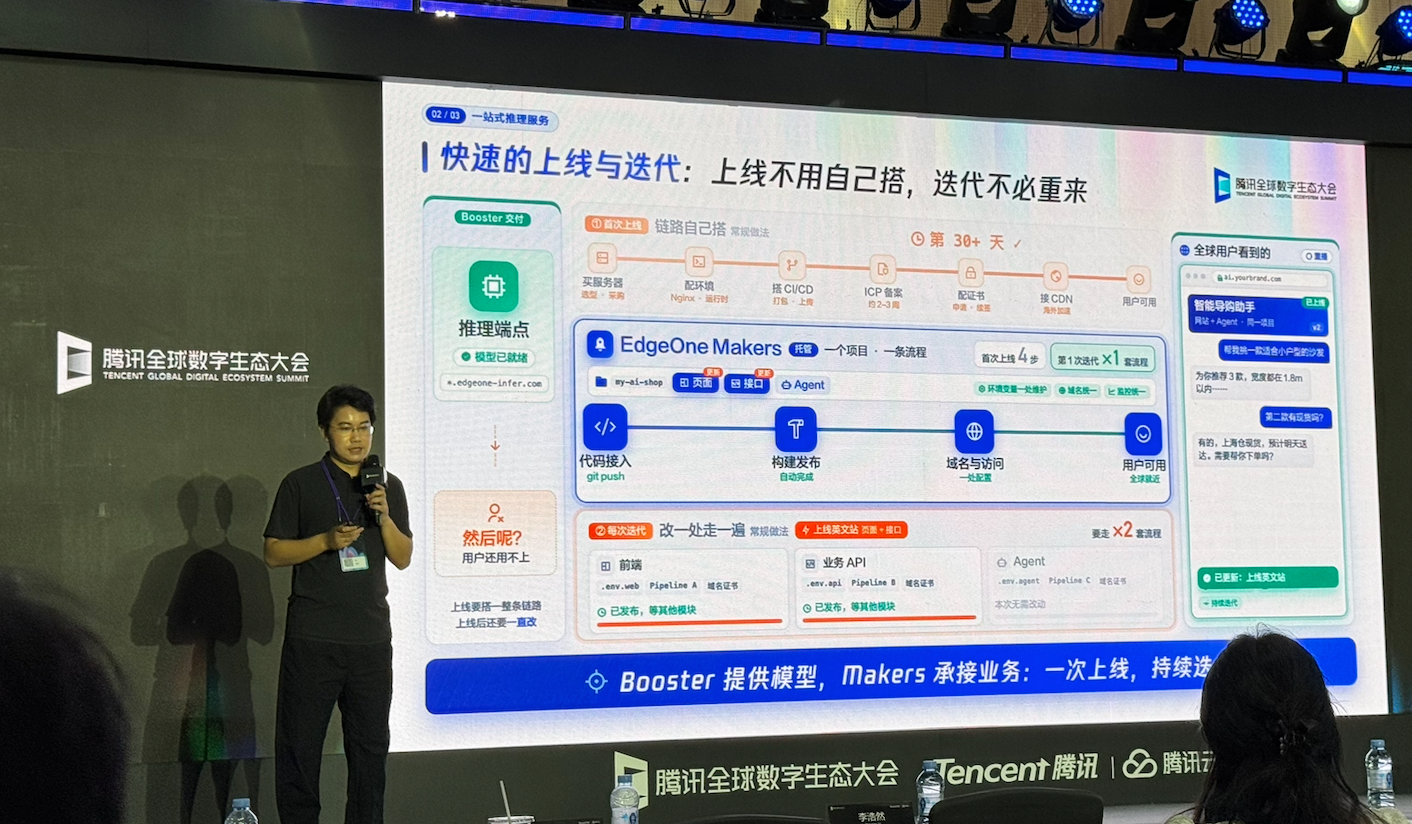
在应用部署层面,腾讯云提供EdgeOne Makers。EdgeOne Makers将应用构建、代码部署、域名管理和全球分发等能力整合到统一项目中,对于需要频繁更新模型、Agent或业务接口的AI应用,这种模式有助于减少重复部署和环境配置工作。
在GPU资源层面,EdgeOne边缘推理服务提供不同规格的GPU实例。例如,大参数模型通常需要更多显存,并可能涉及多卡部署;较小的模型则可以选择成本更低的GPU实例。
平台还提供弹性伸缩能力,在业务高峰时增加推理实例,在流量下降后释放资源。胡兵将这种机制形象地称为算力的呼吸。通过弹性资源供给,企业可以减少为应对短时流量峰值而长期保留大量GPU的情况,显然有助于控制成本。
让CDN参与推理优化,提高GPU利用率
除了网络和资源调度,腾讯云还介绍了多项面向大模型推理的优化技术。
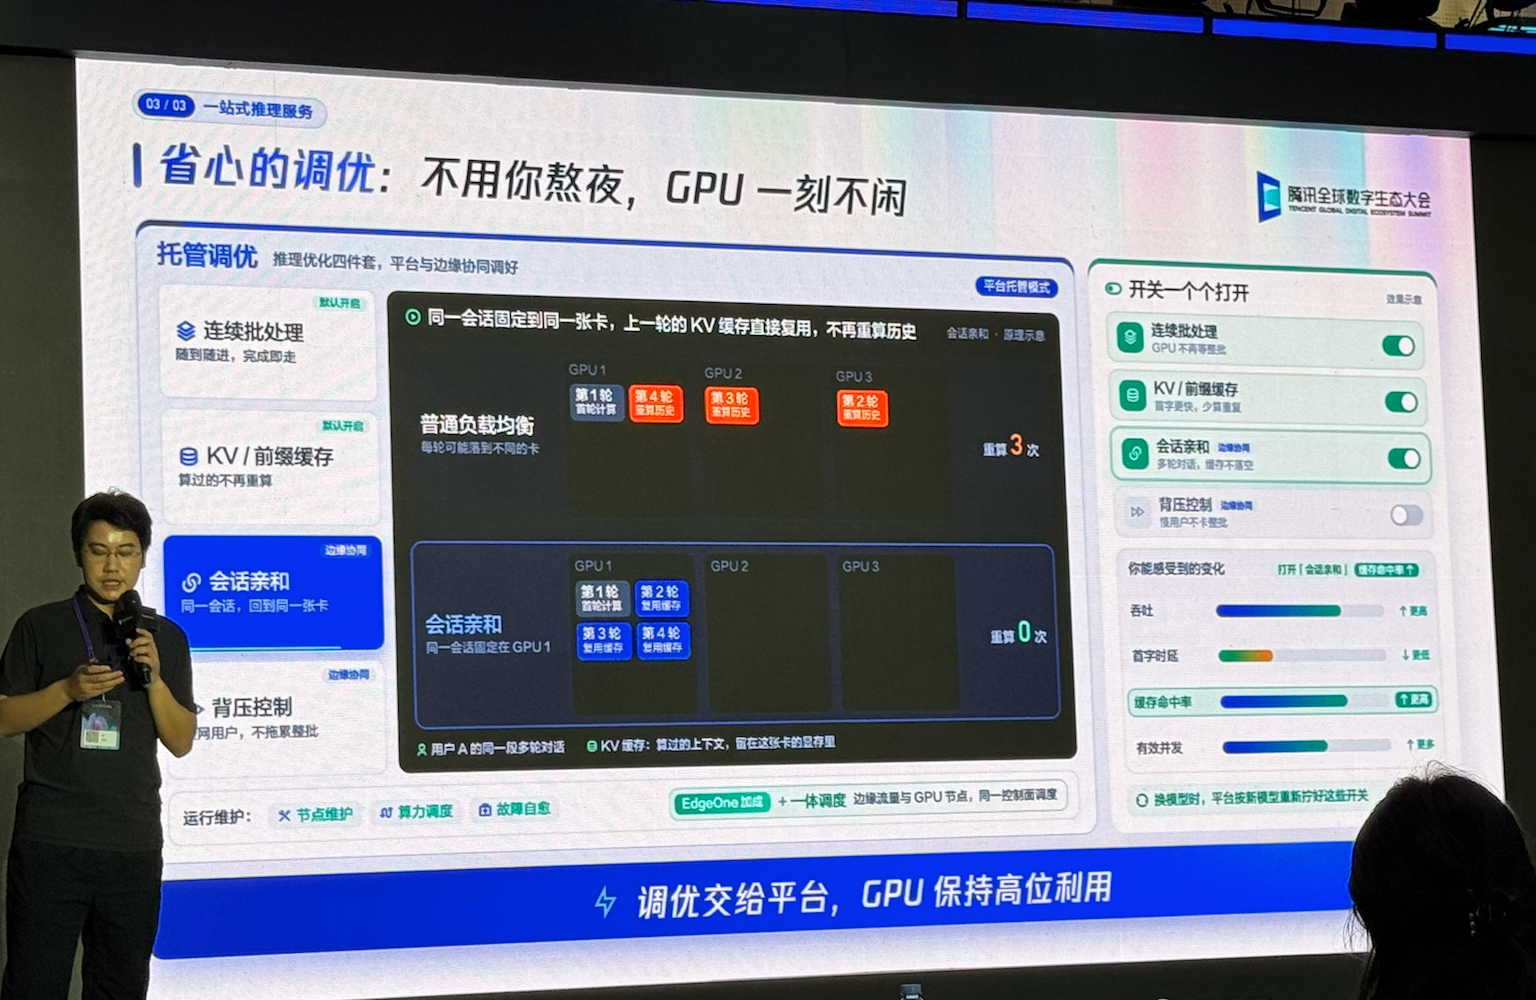
其中,连续批处理能够提高GPU处理并发请求的效率。传统静态批处理通常需要等待一批请求全部完成,而连续批处理可以在推理过程中动态加入新请求,减少GPU计算资源的空闲时间。
另外一项重要技术是KV/前缀缓存技术,大模型在多轮对话中需要处理历史上下文,并利用KV Cache缓存相关计算结果。后续当遇到同样的计算任务就可以直接调用这些数据,而不用重新计算。
与之搭配的还有会话亲和技术。会话亲和的核心作用,就是让同一个用户的多轮AI对话,尽量由同一个GPU实例处理,以便重复利用之前生成的KV Cache,提高KV Cache复用率,更好的减少重复计算,加快AI响应速度。
此外,胡兵还介绍了面向流式推理的背压控制技术。当用户网络较慢时,持续输出Token可能造成缓冲区堆积。通过网络与GPU协同,平台能够感知用户的接收速度,动态调整数据输出和算力分配,提高推理效率。
这类技术充分体现出了算网融合的价值,它让网络不仅负责传输推理结果,还能够将网络状态反馈给计算系统,参与推理性能优化,这是很多人此前完全没想到的。
从语音交互到AI视频,边缘推理正在走向更多场景
腾讯云还分享了EdgeOne边缘推理在多个行业中的应用实践。
比如,在实时语音交互场景,腾讯云与合作伙伴共同优化语音合成服务,通过就近部署推理资源和全球网络加速,将相关语音服务的延迟控制在200毫秒以内。对于语音助手和实时对话应用而言,延迟至关重要。
在AI视频处理场景,腾讯云介绍了面向视频智能剪辑、内容生成等业务的弹性算力支持。这些业务可能在短时间内产生大量并发任务,同时对GPU显存和计算性能提出较高要求。通过弹性调度,平台可以在业务高峰期增加计算资源,提高任务处理能力。
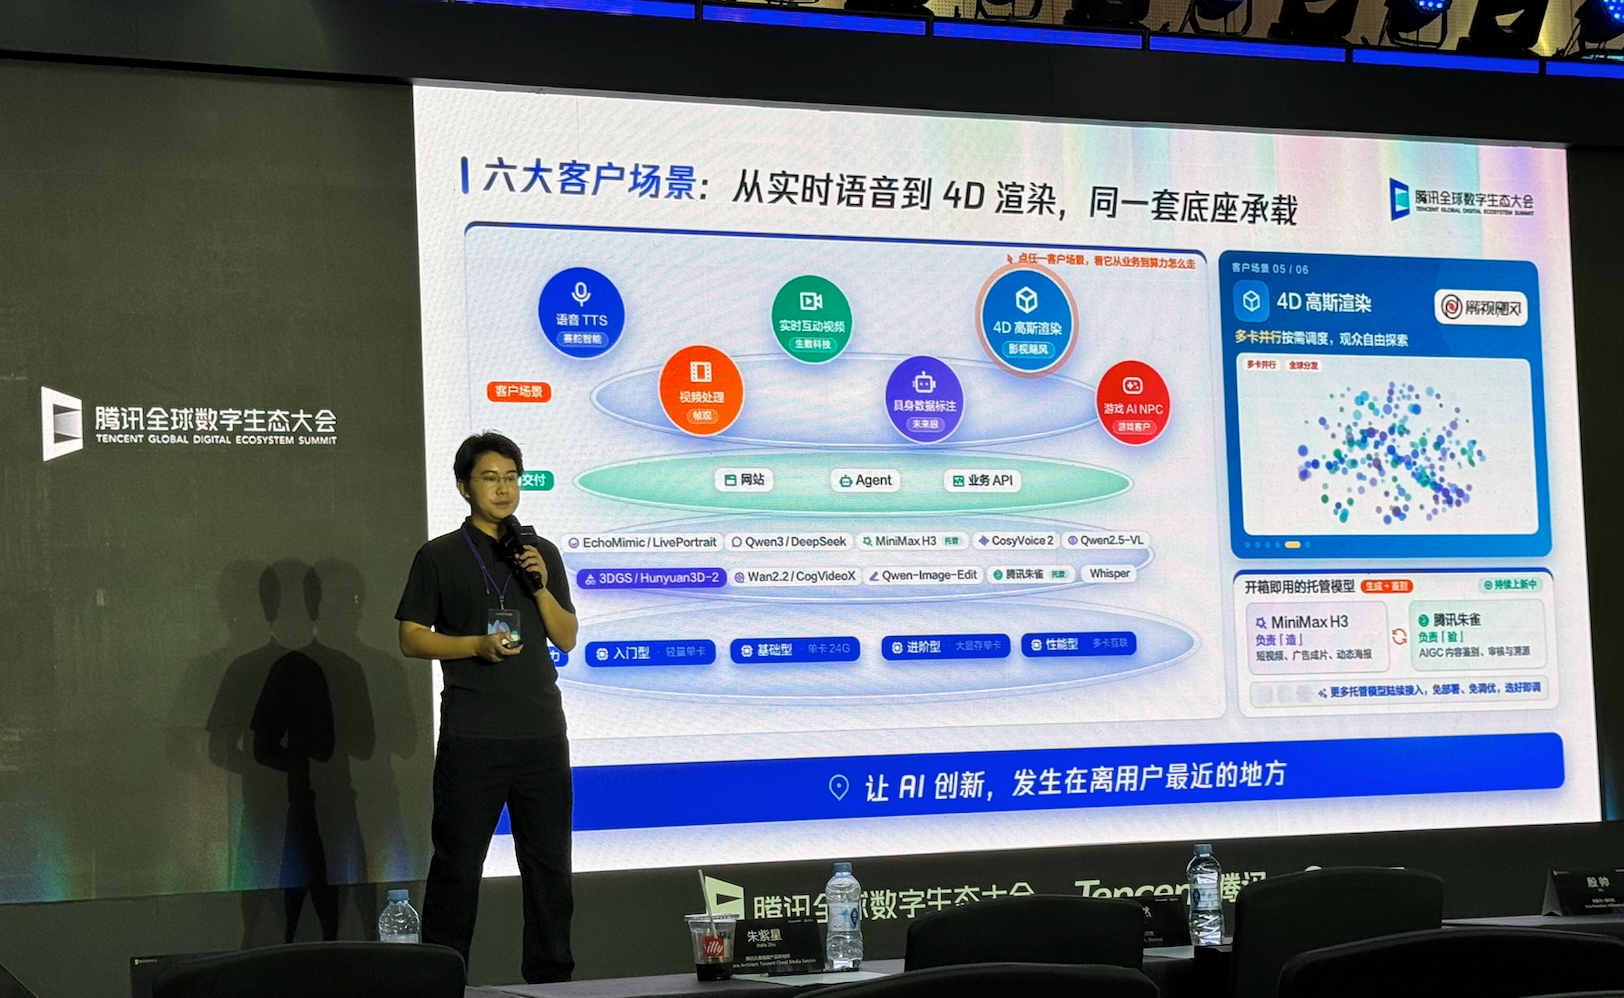
胡兵还特别提到了影视飓风在视频节目中用到的4D高斯渲染技术。通过GPU算力支持,平台为30多位艺人提供素材的3D预处理和4D渲染服务,最终生成具有子弹时间效果的视觉内容。
这些应用虽然具有不同的业务特征,但对基础设施提出了相似的要求,那就是需要根据任务特点,灵活匹配网络延迟、GPU算力和并发处理能力。
CDN正在迎来全新的角色定位
传统CDN的核心价值,是通过内容缓存和就近分发,降低网络延迟及源站压力。但在AI时代,Token需要根据用户输入实时生成,传统内容缓存难以解决全部问题。这使得CDN需要进一步与GPU资源、推理引擎和应用运行环境结合。
腾讯云EdgeOne的探索,正是将原本相对独立的网络加速、算力调度和应用部署能力整合起来,让网络基础设施从内容分发向智能推理服务延伸,逐步演变为连接用户、网络与GPU算力的智能调度基础设施。
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表