导 语
巨头们争相涌入智能体赛道。近一个月,Meta Muse、OpenAI Dots、谷歌Gemini Agent相继落地,目标都是终端用户与企业业务的长任务智能体,竞争焦点集中在模型能力、任务编排与云端会话算力。
而9月30日AMD发布的AMD Ross™另辟蹊径,不做面向业务的应用层智能体,而是扎根芯片开发上游,做一款服务硬件工程师的基础设施型智能体。

距离发布已有一段时间。跳出首发新闻的新鲜感再回看这套产品,它真正的冲击不在于帮工程师少敲几行命令,而在于重新定义智能体时代算力上游的权力分配方式。
先看事情本身
AMD Ross™覆盖嵌入式开发的完整流程,从架构设计、FPGA开发、时序优化、软硬件调试,一直延伸到PCB设计与系统部署。
它不是聊天框里的问答机器人,而是通过MCP服务器直接接入Vivado、Vitis等AMD自有工具链,可以查文档、跑命令、执行专家编写的工作流。
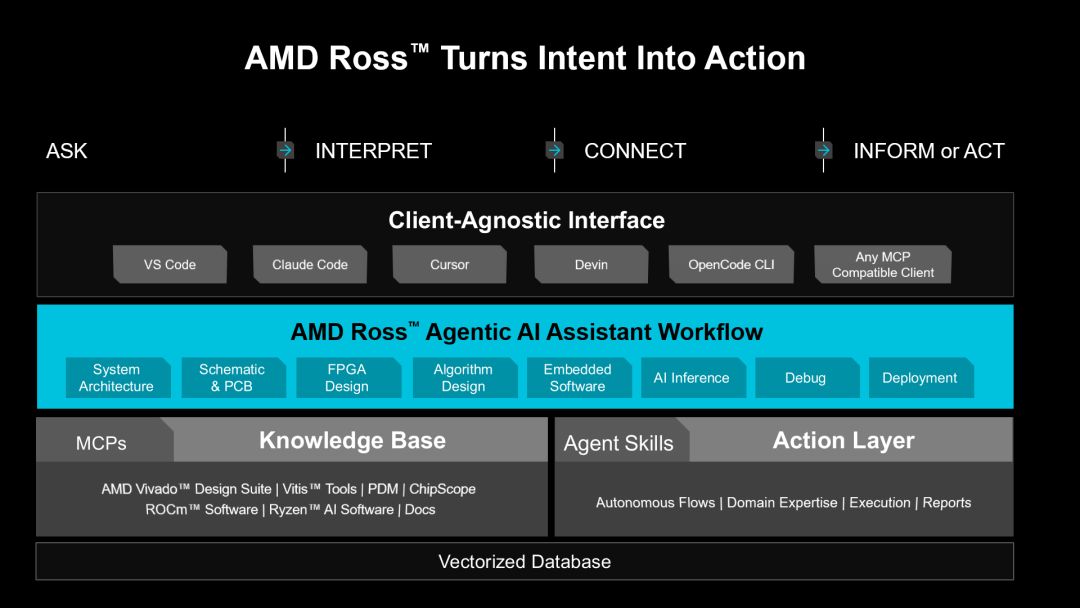
首发功能以Vivado综合布线与Vitis HLS为支点,Q4起按月加入功耗管理、ChipScope、Vitis AI,原理图与PCB审查、x86、ROCm排在明年路线图中。所谓全流程,是一个按月推进的扩展承诺,而非首发即满配。
单看发布稿,这是一次常规的产品迭代。把三个细节连起来看,轮廓就清晰了,AMD在做的不是给工具加个AI功能,而是重新定义开发者与工具链之间的接口。
本质一:入口之争,智能体正在成为工具链的新界面
过去三十年,EDA与芯片厂商的竞争围绕两个层面展开,工具本身的功能强弱,以及芯片本身的性能参数。开发者通过图形界面、脚本和命令行与工具交互,这个界面几十年没有质变。
Ross这类产品的出现,意味着界面层正在被抽离出来。
当工程师用自然语言下达意图、由智能体去调度工具完成操作时,真正被握住的不是工具,而是意图的入口。谁控制了入口,谁就把下游的工具、IP、乃至芯片选型变成了可替换的执行层。
这解释了为什么Ross不惜以客户端无关、模型无关的开放姿态出现。AMD很清楚,在通用大模型层面它不具备主导权,与其封闭竞争,不如把自己钉在模型与硬件之间的动作层这个位置上。开放不是姿态,是卡位。
Ross自身是不运行基础模型的编排层,模型算力由外部LLM提供,可来自云端API,也可来自客户本地部署的开源权重模型。算力并非消失,只是分配路径发生转移。这也意味着未来算力需求不再只有训练、推理两大品类,硬件设计编排、EDA自动化流程有望催生出独立的算力消耗品类。算力厂商不再只比拼卡本身,还要比拼能否嵌入这套工具编排链路。

在AMD内部案例中,Ross优化一条图像传感器去马赛克流水线,两小时完成人工需两天的设计,LUT资源减少35%,吞吐目标不变。AMD自己注明这并非通用基准,但它至少说明,在特定环节,专家经验被编码为智能体技能之后,兑现的效率收益是可测量的。
本质二:壁垒迁移,从卖芯片到卖专家经验
FPGA与自适应SoC开发有一个长期痛点,门槛极高。
时序收敛、HLS优化、功耗估算,这些环节依赖的是散落在资深工程师头脑里的隐性经验,文档只能记录结论,记录不了判断过程。
Ross的核心资产恰恰是这部分。
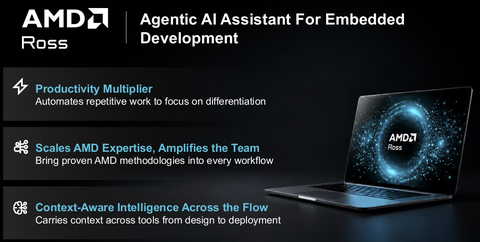
经AMD验证的向量知识库,加上专家编写、以markdown形式开放的智能体技能,实际上是把几十年积累的工程判断力编码成了可复用、可分发的数字资产。
从商业逻辑看,这一步棋有三层收益:
缩短客户的产品上市周期,直接提升AMD器件的竞争力;
降低使用门槛,扩大FPGA开发者基数,把会用AMD工具从稀缺能力变成普适能力;
按月更新的节奏,意味着工具链正在向持续性服务的形态演变。对比传统工具半年一次的大版本节奏,这本身就是一次交付模式的切换。
这套方法论资产,还会反向影响上游硬件选型。当大量开发者依托Ross完成FPGA、嵌入式SoC原型设计,客户的芯片选型、FPGA片上资源配置、本地算力规格,会在设计早期就被这套工作流悄然框定。
模型厂商争夺应用层用户,AMD争夺的是硬件设计阶段的算力定义权,在芯片定型之前就参与算力规格的定义,这是比订单更前置的卡位。
芯片公司的护城河,正在从制程、架构,部分地向知识资产与开发者生态迁移。
本质三:这不是孤例,而是行业转折的侧影
把视野放宽,AMD的动作只是EDA与半导体行业智能化浪潮中的一环。新思、楷登都在把AI助手嵌入设计流程,英伟达则在硬件之上叠加各类生成式工具。
差别在于各自的落点,有的从模拟验证切入,有的从布局布线切入,而AMD选择了自己最擅长、控制力最强的领域,嵌入式与FPGA全栈。
还有一个细节可以佐证这是行业共识而非一家偏好。
10月8日发布的谷歌Gemini Agent,同样通过MCP服务器接入外部工具与技能注册表,MCP正在成为智能体与工具之间的通用连接层,两家头部厂商在同一时间做出了相同的基础设施选择。
这个选择本身暴露了行业转折的方向,AI在芯片行业的价值兑现,不是替代设计师,而是把专家方法论规模化。人才缺口是真实的,上市时间压力是真实的,谁能把老师傅的经验产品化,谁就能在下一轮工具链竞争中占先手。
放在整条算力链视角,这是算力供给逻辑的一次分化。
应用层智能体的算力需求是事后消耗,用户确定业务之后再调用算力。而Ross这类硬件开发智能体,算力需求发生在芯片设计的源头,可能影响未来数年FPGA、边缘芯片乃至服务器的规格。
MCP作为通用连接层,有望打通LLM与更多硬件工具,催生更多上游工程智能体,持续拉动工程仿真与验证类算力需求。

需要泼一盆冷水
客观地说,Ross描绘的图景能否兑现,仍取决于几个未解的问题:
硬件设计中一个错误的pragma建议可能导致时序违例甚至流片失败,AI输出的责任边界如何界定,目前整个行业都没有答案;
智能体可以执行工作流,但结果对不对最终仍需工程师背书,省下的时间可能被验证环节部分吃回去;
云端知识库与本地离线并存是务实设计,但企业级敏感设计的接入深度,将决定其实际渗透速度。
算力层面的风险同样不可忽视。
本地离线乃至气隙部署是Ross的官方选项,数据库、嵌入模型、MCP服务器全部本地运行,这对工程工作站的本地推理算力与内存提出实际要求。
如果大规模企业客户选择本地部署,不会大量消耗云端大卡,但会拉动高端本地工作站与本地向量数据库的算力需求,形成算力市场内部的结构性切换,而不是单纯的总量增长。
结语
Ross的表面是效率工具,里子是位置之争。在模型能力趋于平权的背景下,芯片厂商比拼的下一个对象,是谁能把自己的工具链、知识资产与开发者生态,嵌进智能体时代的基础设施层。嵌入式开发只是第一个滩头阵地,这个逻辑向更复杂的SoC设计延伸,几乎是可以预期的下一步。
当应用层智能体争夺今天的用户时,Ross这类产品争夺的是明天的硬件本身。这场发生在设计源头的暗战,值得算力行业的观察者比消费级产品的喧嚣投入更多注意。
今日参考阅读文章: (1)AMD 为嵌入式设计与开发全周期注入 Agentic AI 强大能力 (链接:https://chinaaet.com/article/3000180829) (2)嵌入式开发进入智能体AI时代!AMD打造最强助手 (链接:https://www.163.com/dy/article/L85GHNO40556OH4N.html) (3)AMD推出Ross智能体AI助手,革新嵌入式开发流程 (链接:https://www.sohu.com/a/1082963139_122066678)
本文来源于DOIT传媒,文章内容仅供参考,不构成投资建议。
评论列表